33
Ubicaciones de monitoreo
18
Países
6
Continentes
75 / 48
Nodos en IPv4 / IPv6
Ubicaciones de monitoreo
Países
Continentes
Nodos en IPv4 / IPv6
Nuestra red global de monitoreo es el conjunto de 33 ubicaciones de monitoreo desde las cuales Dotcom-Monitor realiza sus comprobaciones — 18 países, 6 continentes, cada uno un nodo de monitoreo en un centro de datos comercial con sus propias direcciones IP publicadas. Cuando configuras un monitor, eliges cuáles de estas ubicaciones lo ejecutan. Cada ubicación seleccionada ejecuta la comprobación completa de forma independiente e informa sus propios tiempos, códigos de estado y errores, por lo que un problema que sólo existe en una parte del mundo aparece como un problema en esa parte del mundo.
Las ubicaciones ejecutan todos los tipos de comprobaciones que la plataforma soporta: cargas de páginas con navegador real y transacciones multi-paso EveryStep, llamadas API REST, SOAP y GraphQL, y comprobaciones a nivel de protocolo como DNS, SSL, SMTP, FTP, puerto TCP, ping y traceroute. No hay un conjunto de características reducido en el borde — una comprobación en Sídney es la misma comprobación que una en Chicago.
Una aclaración, porque los nombres son similares. Esta página trata sobre desde dónde monitorizamos: nuestra propia infraestructura y su cobertura geográfica. No trata sobre monitorear la red que posees. Si lo que necesitas es comprobar la accesibilidad, latencia, enrutamiento y pérdida de paquetes contra tus propios hosts, routers y circuitos — monitorización de ping, traceroute y puertos TCP dirigida a tu infraestructura — eso es monitorización de red, y tiene su propia página. Los dos trabajan juntos: la monitorización de red es lo que compruebas, la red global de monitoreo es desde dónde lo compruebas.
Las 33 ubicaciones, agrupadas por región. Cada una de ellas está disponible para cada dispositivo de monitoreo en tu cuenta — no hay un nivel premium de ubicaciones “globales” reservado para planes superiores.
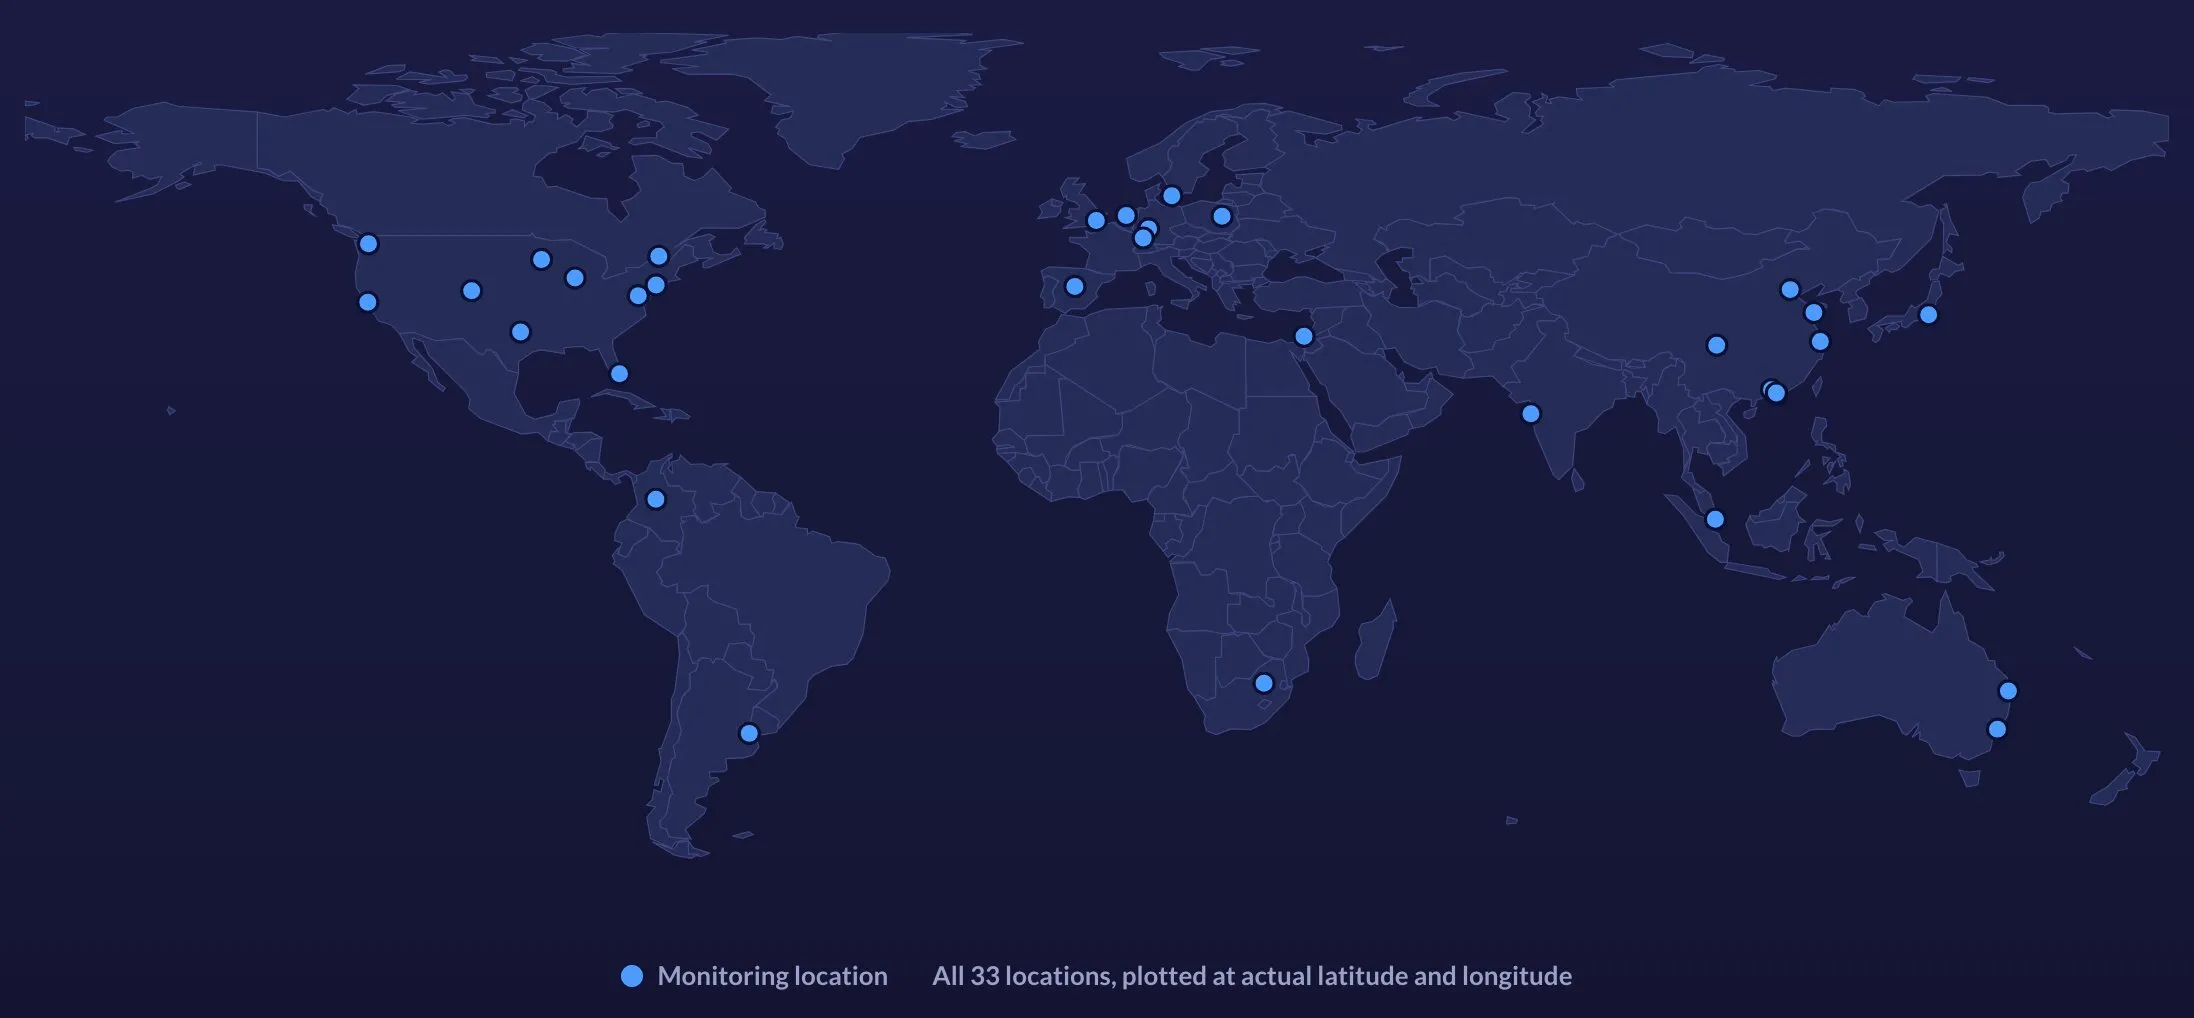
El mapa es un índice visual. La lista autorizada es el texto debajo de él — y en tu cuenta, donde cada ubicación aparece por nombre en la pantalla de configuración del dispositivo.
¿Necesita nuestras IPs? La mayoría de los equipos las quiere por dos razones: para filtrar el tráfico sintético de sus análisis y para permitir que nuestros agentes pasen a través de un WAF o firewall. Los rangos actuales de IPv4 e IPv6 para cada ubicación están publicados y mantenidos en la base de conocimientos — vea el artículo direcciones IP de ubicaciones de monitoreo. Deliberadamente los mantenemos allí en lugar de en esta página, porque las direcciones cambian y ese artículo es la fuente de verdad mantenida. Esas direcciones también le permiten verificar nuestro hosting por sí mismo: busque cualquiera de ellas en whois o RDAP y verá la red y el proveedor en la que se encuentra esa ubicación.
En las 33 ubicaciones operamos 75 nodos de monitoreo en IPv4 y 48 en IPv6. Veintiséis de las 33 ubicaciones responden en ambos protocolos, por lo que la mayoría de la red es genuinamente dual-stack en lugar de IPv4 con un túnel. Siete ubicaciones son solo IPv4 — Buenos Aires, Varsovia, Tel Aviv, Hong Kong, Qingdao, Tokio y Singapur — y un nodo, en San Francisco, es solo IPv6 sin ninguna dirección IPv4.
El nodo solo IPv6 es el que importa. En un host dual-stack, un cliente que falla con IPv6 usualmente vuelve rápido a IPv4 para que nada parezca roto — Happy Eyeballs oculta la falla por diseño. Así que una sonda dual-stack puede reportar un sitio saludable mientras sus usuarios solo IPv6 no pueden acceder a él. Una sonda solo IPv6 no tiene a dónde volver: si falta el registro AAAA, el registro apunta a la dirección equivocada, la regla de firewall fue escrita solo para v4 o el balanceador de carga nunca tuvo un listener v6, la comprobación falla y usted se entera.
Esta no es una audiencia teórica. Grandes operadores móviles usan redes de acceso solo IPv6 con NAT64 en el borde, y compras de empresas y gobiernos en varios países exigen alcance IPv6. El monitoreo single-stack nunca ve nada de esto.
Lo que puede probar | Dónde se ejecuta | Lo que detecta |
|---|---|---|
Comprobaciones IPv4 | 75 nodos en las 33 ubicaciones | La base que cubre cualquier proveedor — accesibilidad, latencia y enrutamiento sobre IPv4 desde seis continentes. |
Comprobaciones dual-stack | 48 nodos IPv6 en 26 ubicaciones | Diferencias en latencia, enrutamiento y comportamiento TLS entre los dos protocolos desde la misma ciudad. |
Comprobaciones solo IPv6 | Un nodo en San Francisco, sin dirección IPv4 | Registros AAAA faltantes o incorrectos, reglas de firewall y WAF solo v4, balanceadores de carga sin listener v6 — fallos que la conmutación a IPv4 oculta en todas partes. |
La dirección de cada nodo se publica: las direcciones IPv6 para cada ubicación están junto a sus direcciones IPv4 en el artículo de direcciones IP de ubicación de monitoreo, que es de donde provienen los recuentos de nodos mencionados arriba. Puedes contarlos tú mismo.
El monitoreo de una sola ubicación responde a una pregunta: ¿está el sitio activo para esa única máquina? Todo lo demás está invisible para ella.
Las regiones en la nube, proveedores de tránsito y el IX peering fallan de manera regional, no global. Un corte en eu-central afecta a tus clientes europeos mientras todas las verificaciones en EE. UU. permanecen en verde. Sin sondas europeas, tu primera señal es un ticket de soporte.
Ambos son sistemas geográficos por diseño. Una caché edge obsoleta, un PoP mal enroutado o una respuesta GeoDNS incorrecta afecta una región a la vez. Lo detectas comparando la misma verificación a través de continentes.
Una página que se carga en 1.2 s desde Chicago puede tardar 5 s desde Sídney o Johannesburgo — los viajes de ida y vuelta TLS, la distancia y los activos no cacheados se acumulan. Las líneas base por ubicación te indican qué mercados necesitan presencia en el edge.
Algunas obligaciones son geográficas: demostrar disponibilidad a clientes en un país específico, verificar que el contenido geo-restringido funcione correctamente, o evidenciar el cumplimiento del SLA desde donde el cliente realmente está.
La forma más rápida para que un equipo de guardia ignore tu monitoreo es hacer que los notifiques por un fallo momentáneo en una sola sonda. Una verificación fallida no es evidencia de que un sitio está caído — es evidencia de que una ruta entre una máquina y tu sitio falló una vez. Son afirmaciones diferentes, y la red te da la segunda constantemente: un cambio transitorio de ruta, una pérdida momentánea de paquetes, un nodo edge con limitación de tasa, un error del resolvedor.
La verificación desde múltiples ubicaciones resuelve la ambigüedad antes de que una alerta salga de la plataforma:
La verificación se registra como un error en esa ubicación, con la respuesta completa, encabezados y tiempos capturados para el postmortem. Aún no se envía nada.
El mismo dispositivo, el mismo script, los mismos umbrales — ejecutados desde ubicaciones de monitoreo independientes en diferentes redes, en distintos países.
Si las otras ubicaciones tienen éxito, la falla fue local en un camino y el incidente no se abre. Si también fallan, el corte es real y está confirmado desde múltiples continentes.
La notificación lleva la evidencia consigo — qué ubicaciones fallaron, cuáles tuvieron éxito y qué vio cada una — encaminada a través de tus reglas de alertas y el programa de escalación.
El resultado es una alerta sobre la cual tu equipo puede actuar sin tener que revisarla manualmente primero. También muestra el caso opuesto: cuando varias ubicaciones fallan y algunas funcionan, no estás viendo un corte total — estás viendo un corte regional, y la lista de ubicaciones que fallaron ya es la primera pista sobre dónde.
Nuestras 33 ubicaciones públicas alcanzan todo lo que puede alcanzar la internet pública. Aplicaciones intranet, APIs internas, entornos de prueba e infraestructura detrás de un firewall, por diseño, no están en esa lista.
Para esos casos, instala un agente privado — el mismo software de nodo de monitoreo, funcionando en tu propio hardware dentro de tu propia red. Aparece en tu cuenta como otra ubicación de monitoreo, alimenta los mismos tableros, informes y alertas, y comunica solo de salida, por lo que no se necesitan reglas de firewall de entrada. Los equipos comúnmente ejecutan la misma verificación desde una ubicación pública y un agente privado al mismo tiempo: cuando la verificación pública falla y la interna pasa, la falla está entre tu perímetro e internet, no en la aplicación.
Ejecuta monitoreo desde dentro de tu firewall contra aplicaciones internas, APIs e infraestructura que la internet pública no puede alcanzar.
Comprobaciones de ping, traceroute y puerto TCP dirigidas a tus propios hosts y rutas — desde fuera hacia dentro y desde dentro hacia fuera.
Envía incidentes confirmados a la persona de guardia correcta mediante correo electrónico, SMS, teléfono, Slack, PagerDuty y webhooks.
Desde 33 ubicaciones de monitorización en 18 países de 6 continentes: 10 en Norteamérica, 7 en Europa, 12 en Asia y el Pacífico, y 4 entre Sudamérica, Medio Oriente y África. Cada ubicación está nombrada en esta página, y las direcciones IP actuales de cada una se publican en el artículo de la base de conocimiento direcciones IP de las ubicaciones de monitorización.
Sí, por dispositivo de monitorización. Usted selecciona las ubicaciones cuando crea o edita un dispositivo, y puede cambiar la selección en cualquier momento. La mayoría de los equipos escogen unas pocas que reflejan donde realmente están sus usuarios, luego agregan ubicaciones para investigar un mercado específico. Cada ubicación seleccionada ejecuta la comprobación en el intervalo que usted elija y reporta sus propios resultados, para que pueda compararlos lado a lado.
Sí. Operamos 75 nodos de monitorización en IPv4 y 48 en IPv6. Veintiséis de las 33 ubicaciones son dual stack y responden en ambos protocolos; las siete que solo usan IPv4 son Buenos Aires, Varsovia, Tel Aviv, Hong Kong, Qingdao, Tokio y Singapur. Un nodo, en San Francisco, es solo IPv6 sin dirección IPv4 alguna. Ese nodo solo IPv6 es el que detecta registros AAAA faltantes, reglas de firewall solo IPv4 y balanceadores de carga sin un listener v6 — fallos que la retrocompatibilidad con IPv4 oculta en todas las comprobaciones dual stack.
Todas. Cada ubicación de monitorización está disponible en todos los planes; no hay un nivel geográfico que limite las ubicaciones “globales”. Lo que varía entre planes es el número de dispositivos de monitorización y la frecuencia con la que se ejecutan — consulte la página de precios para los límites actuales, o inicie una prueba gratuita y configure las ubicaciones que necesite.
Sí, usando agentes privados. Un agente privado es el mismo software de nodo de monitorización instalado en su propio hardware dentro de su red, por lo que puede alcanzar aplicaciones intranet, APIs internas e infraestructura protegida por firewall. Aparece en su cuenta como una ubicación adicional de monitorización y provee los mismos informes y alertas que nuestras ubicaciones públicas, comunicándose solo de salida.
Cuando una ubicación reporta una falla, la plataforma vuelve a ejecutar la misma comprobación desde otras ubicaciones antes de abrir un incidente. Si las otras tienen éxito, la falla era local en una ruta de red y no se envía alerta. Si también fallan, la interrupción se confirma desde redes independientes en diferentes continentes y se dispara la alerta con la evidencia por ubicación adjunta. Esa es la diferencia entre una página sobre la que puede actuar y una página que aprende a ignorar.
Inicie una prueba gratuita de 30 días, direccione un monitor a su sitio y seleccione todas las ubicaciones que le interesen. No se requiere tarjeta de crédito.
Acceso completo a la plataforma durante la prueba — todas las ubicaciones de monitorización, todos los tipos de comprobación, no se requiere tarjeta de crédito.