Organisations dans le monde entier
SLA de disponibilité de la plateforme
Lieux de surveillance mondiaux
Leader de la surveillance de sites web
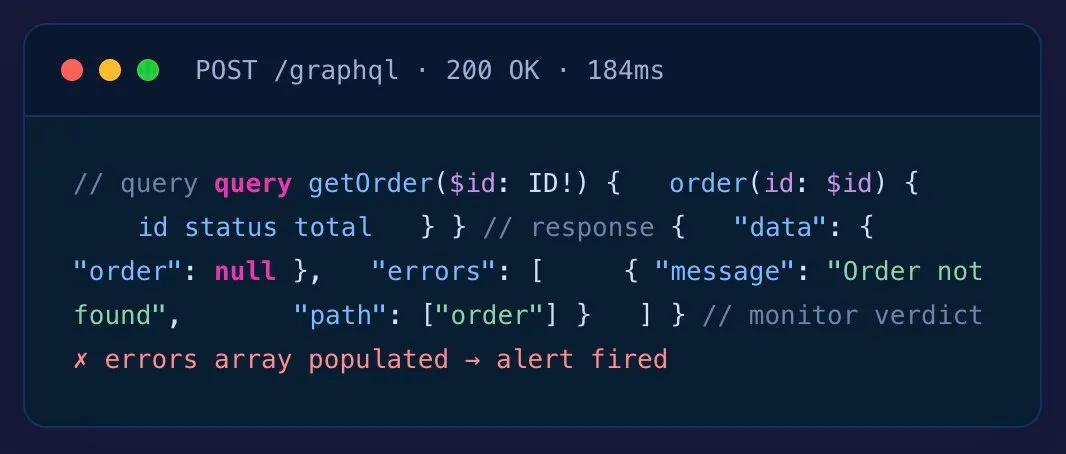
La surveillance de l’API GraphQL est un test conscient des requêtes des points de terminaison GraphQL depuis l’extérieur de votre infrastructure — inspectant le tableau errors du corps de réponse et la forme de data (puisque le statut HTTP est généralement 200 même en cas d’échec), mesurant la latence des requêtes, et alertant en cas d’échecs.
Le grand avantage de GraphQL — un seul endpoint, des requêtes flexibles — est aussi la raison pour laquelle la surveillance limitée à la disponibilité vous trompe. Le mode d’échec important se trouve dans le corps de la réponse, pas dans le code de statut.
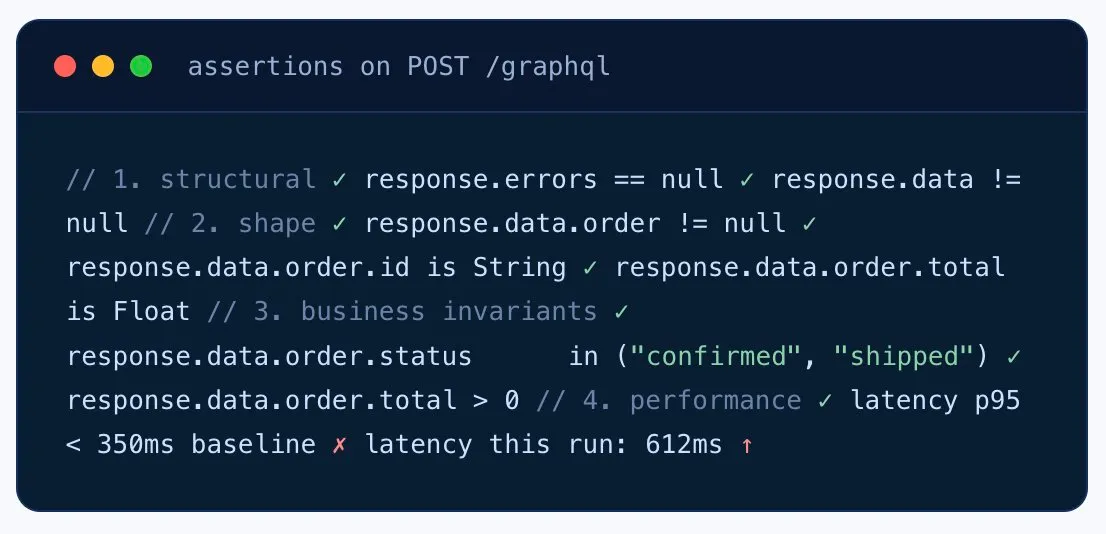
Envoyez une charge utile de requête définie, puis effectuez des assertions sur le corps de la réponse. Chaque moniteur sait si le tableau errors est apparu, si data contient la structure attendue, et si les invariants métier tiennent.
errors[].length > 0.
data pour détecter les champs nuls et les clés manquantes.
data.order.status == "confirmed".
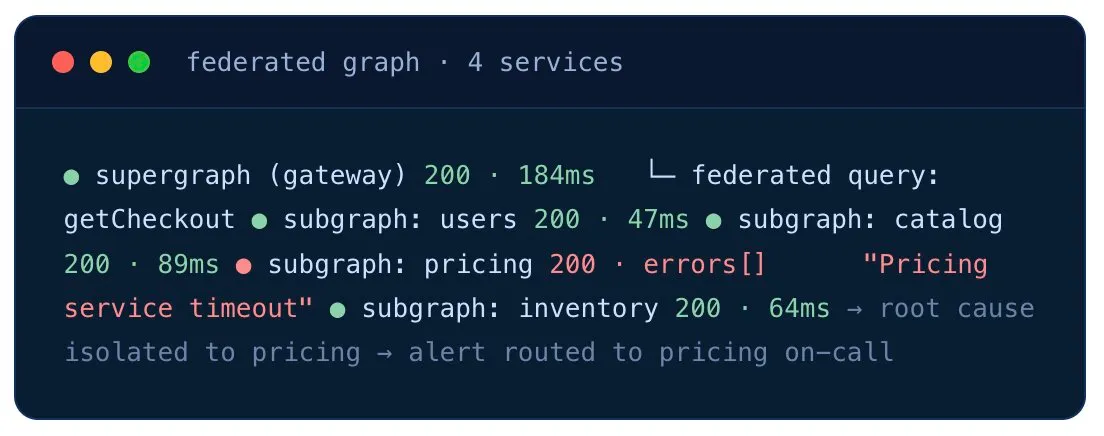
Une configuration GraphQL fédérée masque les échecs des services en aval derrière la passerelle. Surveillez le supergraphe pour détecter les défaillances visibles par le client — et les sous-graphes individuels pour identifier le service en cause.
Le point de terminaison GraphQL unique dont dépend votre application mobile. Capturez la défaillance partielle silencieuse qui renvoie un 200-avec-erreurs et affiche un écran vide aux utilisateurs.
Supergraphe + sous-graphes surveillés séparément. Lorsque la requête fédérée échoue, les moniteurs de sous-graphes vous indiquent quel service en aval réveiller.
placeOrder, processPayment, submitClaim — les mutations qui déplacent de l’argent ou modifient l’état. Surveillez chacune individuellement, en validant les invariants des données.
Lancez la surveillance depuis le CI après chaque déploiement. Repérez le changement de schéma qui met silencieusement un champ à null, ou le renommage du résolveur qui casse l’application mobile.
Suivez la latence P95/P99 par requête. Repérez le résolveur coûteux qui dépasse la base avant que les avis mobiles ne chutent.
Pour les abonnements GraphQL basés sur WebSocket, vérifiez que la connexion s’établit, reçoit des messages et reste active — en utilisant notre surveillance WebSocket.
Un ingénieur en performance vous expliquera la surveillance GraphQL avec détection d’erreurs sous forme de tableau et routage de fédération — sans discours commercial, juste un moniteur fonctionnel à la fin de l’appel.
Plus de 30 emplacements de surveillance en propre sur six continents. Repérez le problème régional du CDN ou la faute de routage du gateway edge que les tests locaux manquent.
Pour les services internes BFF GraphQL et les graphes backend uniquement, déployez un Agent Privé à l’intérieur de votre VPC — même profondeur de surveillance, aucune règle de pare-feu entrante.
Emplacements de surveillance mondiaux
Continents couverts
Intervalle de vérification minimum
Pour les environnements derrière un pare-feu

4.5
83 avis
4.6
4.6
Toutes les avis proviennent de avis vérifiés Capterra. Évaluations au août 2026.
Vous voulez essayer sans vous engager ? Plan Gratuit à Vie disponible — jusqu’à 25 cibles, 2 emplacements de surveillance, 7 jours de rétention des données. Commencer gratuitement → ou Comparer les plans
La plupart des implémentations GraphQL retournent un HTTP 200 même lorsque la requête échoue. Les échecs se trouvent dans le corps de la réponse — dans le tableau errors, ou sous forme de valeurs nulles dans l’objet data — pas dans le code de statut. La surveillance basée uniquement sur la disponibilité marque les API GraphQL défaillantes comme saines. Une vraie surveillance GraphQL doit inspecter la charge utile de la réponse. Voir la surveillance d’API REST →
Envoyez une charge utile de requête spécifique, puis vérifiez le corps de la réponse. Contrôlez si le tableau errors de premier niveau est présent ou rempli, validez les invariants de données spécifiques à la requête dans la réponse, et signalez les valeurs nulles dans les champs non nullables. Certains serveurs GraphQL encodent les échecs métier dans l’objet data plutôt que de remplir les erreurs — les deux signaux sont vérifiés.
Oui. Chaque moniteur exécute une charge utile de requête ou mutation définie. Surveillez individuellement vos mutations les plus critiques (placeOrder, processPayment) pour suivre la latence, le taux d’erreur et le taux d’échec partiel par opération.
Tous les schémas d’authentification courants : Bearer Token (le plus commun pour GraphQL), OAuth 2.0 avec rafraîchissement automatique, JWT, clé API, authentification basique, AWS Signature v4, mTLS et en-têtes personnalisés. Les secrets sont masqués via Secure Vault. Voir la matrice d’authentification →
Oui. Surveillez le point d’accès supergraph pour vérifier que la passerelle de fédération est saine, et surveillez les points d’accès des sous-graphes individuels pour isoler quel service échoue lorsqu’une requête fédérée échoue. Fonctionne avec Apollo Federation et architectures similaires.
La latence totale de la requête est suivie, avec les percentiles P95/P99 par requête. Pour identifier les résolveurs individuels lents, combinez la surveillance avec votre traçage APM — la surveillance synthétique confirme la lenteur côté client; l’APM confirme quel résolveur est le goulot d’étranglement.
Oui. Déployez des Agents Privés dans votre VPC ou datacenter — courant pour les services GraphQL backend-for-frontend (BFF) qui ne sont pas exposés publiquement.
La surveillance peut inclure des requêtes à différents niveaux de profondeur et de complexité pour vérifier que vos limites de throttle et de complexité sont appliquées. Combinez avec votre WAF ou middleware de complexité de requête pour une protection complète.
Les abonnements GraphQL utilisent généralement WebSocket — consultez notre surveillance WebSocket pour l’établissement de la connexion, la livraison des messages et les vérifications keepalive.
Surveillez le point de terminaison supergraph pour vérifier que la passerelle de fédération est saine ET surveillez séparément les points de terminaison des sous-graphes individuels pour isoler quel service en aval échoue lorsqu’une requête fédérée rencontre un problème. Les deux moniteurs partagent des routes d’alerte pour une réponse consolidée aux incidents.
Les abonnements GraphQL utilisent le transport WebSocket. Utilisez notre produit de surveillance WebSocket pour valider que la connexion d’abonnement s’établit correctement, reçoit les événements attendus et reste active lors de sessions de longue durée.
Oui. Configurez les identifiants de requête persistante (Apollo Persisted Queries ou hachages de type Relay) dans la requête et Dotcom-Monitor les enverra comme référence d’opération plutôt que la chaîne de requête complète.
Créez des moniteurs à une profondeur et une complexité croissantes pour vérifier que votre middleware de limitation de complexité applique correctement le seuil. Associez la configuration du moniteur à vos règles de complexité du serveur GraphQL.
Vous surveillez plus que GraphQL ? Découvrez la plateforme complète de surveillance API →
Essai gratuit de 30 jours. Aucune carte de crédit. Surveillance consciente du contenu depuis plus de 30 emplacements globaux.