
Organisations dans le monde entier
SLA de disponibilité de la plateforme
Emplacements mondiaux de surveillance
Leader de la surveillance de sites web
La surveillance REST API est le test continu des points de terminaison HTTP REST depuis l’extérieur de votre infrastructure — validant la disponibilité, le temps de réponse, la structure de la charge JSON et les flux d’authentification, puis alertant dès qu’un de ces éléments est défaillant. Contrairement à des tests ponctuels, elle fonctionne 24h/24 et 7j/7 depuis plusieurs emplacements mondiaux selon une cadence fixe.
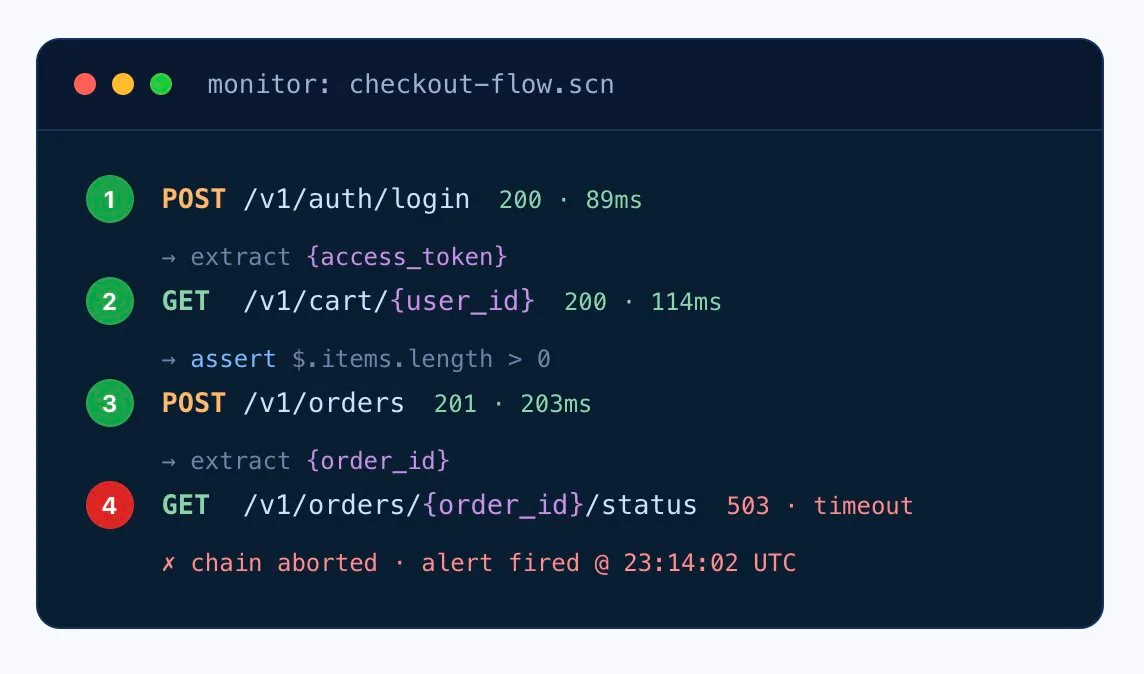
Un /health check fonctionnel ne prouve pas que la logique métier de votre entreprise fonctionne toujours. Dotcom-Monitor enchaîne de vraies séquences — auth → fetch → mutate → verify — et valide chaque étape. Dès que la chaîne se casse, vous savez exactement où, pourquoi et à quoi ressemblait la charge utile de la réponse.
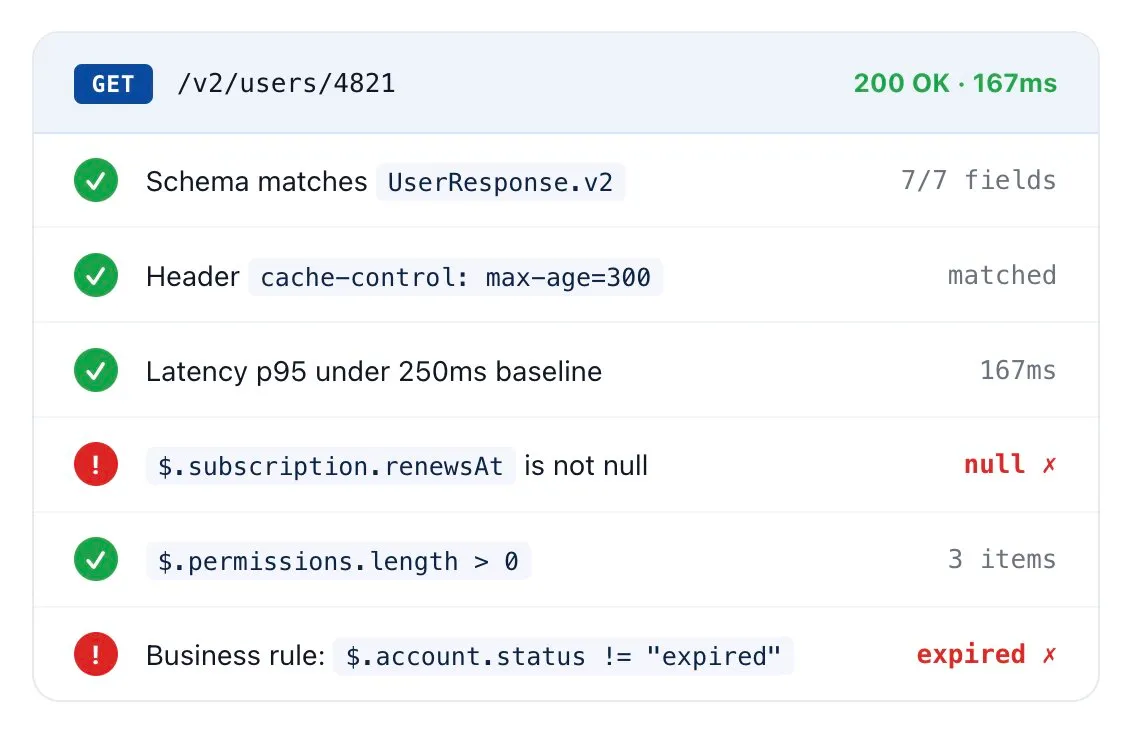
La moitié des échecs d’API renvoient un 200. Dotcom-Monitor inspecte le statut, les en-têtes, le schéma JSON, les nœuds XML et les champs de réponse individuels — puis n’escalade que ce qui compte réellement, pour que votre astreinte n’apprenne pas à ignorer les alertes.
$.order.total > 0 ou $.status == "success".
Scénarios réels d’équipes gérant des API REST en production à grande échelle. Chacun d’eux peut être actif sur votre compte en moins d’une heure.
Enchaînez authentification, récupération du panier, passage de commande, et interrogation de confirmation. Détectez la panne partielle où la connexion fonctionne mais la commande échoue silencieusement avec un 503.
Validez que les webhooks de votre fournisseur arrivent au bon endpoint avec le bon schéma — et que les vôtres déclenchent en aval lorsqu’ils sont activés.
Tenez Stripe, Twilio, Auth0 ou tout fournisseur en amont responsable. Suivez la latence et le taux d’erreur par rapport au SLA qu’ils vous ont vendu.
Effectuez les mêmes vérifications depuis plus de 30 emplacements. Détectez la mauvaise configuration CDN qui n’apparaît que depuis l’APAC, ou le déploiement DNS qui ne s’est pas propagé à l’UE-Ouest.
Déclenchez des exécutions de moniteur depuis votre pipeline CI après déploiement. Conditionnez la mise en production aux résultats des assertions — bloquez les builds défectueux avant qu’ils n’atteignent le trafic de production.
Déployez un Agent Privé à l’intérieur de votre VPC. Surveillez les appels REST interservices de la même manière que vous surveillez les API publiques — sans règles de pare-feu entrantes.
Un ingénieur en performance vous guidera à travers votre premier moniteur REST multi-étapes — authentification en chaîne → récupération → assertion — sans argumentaire commercial, juste un moniteur fonctionnel à la fin de l’appel.
Dotcom-Monitor exploite sa propre infrastructure de surveillance dans plus de 30 emplacements sur six continents — y compris des agents privés que vous pouvez déployer à l’intérieur de votre VPC, derrière des pare-feu, ou sur site.
Cela signifie que vous détectez la panne régionale, le retard de propagation DNS, la mauvaise route CDN — pas seulement la panne globale.
Emplacements de surveillance globaux
Continents couverts
Intervalle minimum de contrôle
Pour derrière le pare-feu

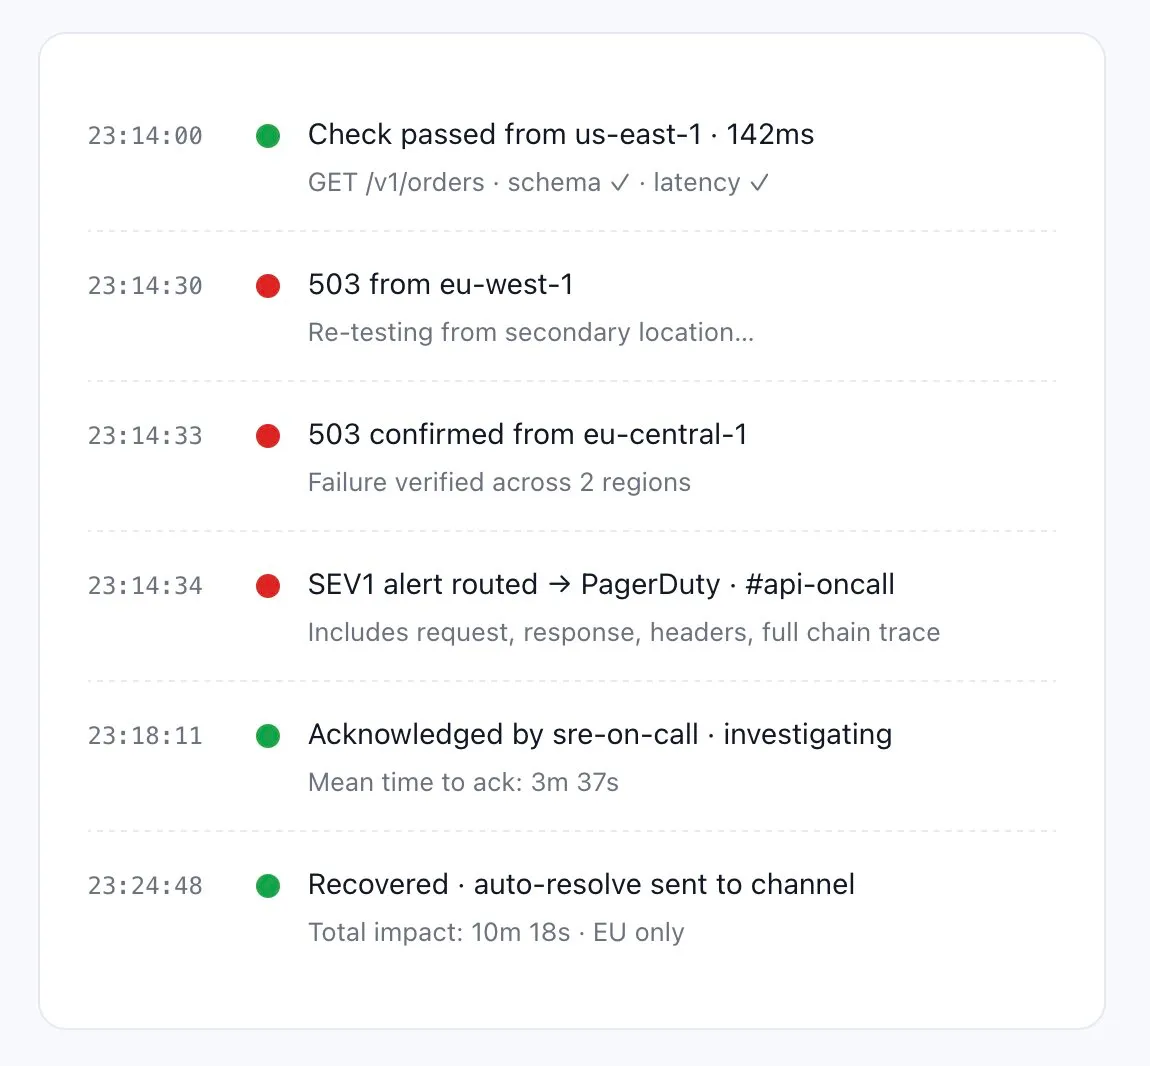
Les alertes à 3h du matin ne fonctionnent que lorsqu’elles sont fiables. Dotcom-Monitor dirige selon la gravité, supprime le bruit, et donne au répondant tout ce dont il a besoin pour diagnostiquer en une notification — la requête en échec, le corps de la réponse, quelles assertions ont échoué, et quels emplacements l’ont vu.
4.5
83 avis
4.6
4.6
Tous les avis proviennent de avis vérifiés Capterra. Évaluations au août 2026.
Vous voulez tester sans vous engager ? Plan Gratuit à Vie disponible — jusqu’à 25 cibles, 2 emplacements de surveillance, 7 jours de conservation des données. Commencer gratuitement → ou Comparer les plans
Tests continus et automatisés des points de terminaison REST depuis l’extérieur de votre infrastructure — vérification de la disponibilité, du temps de réponse et de la justesse des données, puis alertes à votre équipe dès qu’une anomalie est détectée. Contrairement aux tests ponctuels, la surveillance s’exécute 24h/24 et 7j/7 depuis plusieurs emplacements mondiaux selon une cadence fixe.
Oui. Clé API, Basic Auth, OAuth 2.0 (Client Credentials et Authorization Code), JWT avec rafraîchissement automatique, en-têtes personnalisés, mTLS, et AWS Signature v4. Les secrets sont masqués via le Coffre-fort sécurisé.
Oui — c’est le cœur de la surveillance multi-étapes. Transmettez des jetons, identifiants et valeurs dynamiques entre les étapes, validez chaque étape indépendamment, et interrompez la chaîne dès la première erreur avec des journaux complets des requêtes/réponses par étape.
Oui. Déclenchez des exécutions de moniteur via API depuis GitHub Actions, Jenkins, Azure DevOps, ou tout outil CI/CD. Conditionnez le déploiement à la disponibilité, à la latence ou aux résultats d’assertion pour empêcher les builds défaillants d’atteindre la production.
Aussi souvent qu’à chaque minute par point de terminaison, avec des intervalles personnalisés disponibles par moniteur. Pour les parcours critiques comme la connexion ou le paiement, nous recommandons des vérifications toutes les minutes ; pour des points moins critiques, des intervalles de 5 ou 15 minutes.
Oui. Déployez des Agents Privés légers dans votre réseau — ils initient des connexions sortantes vers la plateforme, donc aucune règle entrante sur le pare-feu n’est nécessaire. Vous bénéficiez de la même profondeur de surveillance pour les microservices internes que pour les API publiques.
Les outils de disponibilité vous signalent en vert lorsque vous recevez un code 200. Nous validons la réponse réelle — schéma JSON, en-têtes, contenu du payload, percentiles de latence, réussite de la chaîne en aval — ainsi les échecs partiels (le type 200-mais-défectueux) sont détectés avant que les utilisateurs ne les remarquent.
Oui. Diffusez les métriques de disponibilité, latence et erreurs via un flux XML dans Grafana, Prometheus, Power BI ou votre propre stack BI. L’API expose également des données historiques pour des tableaux de bord et rapports personnalisés.
Toujours les erreurs 5xx (problèmes serveur). Les erreurs 4xx de manière sélective — alerter sur les pics 401/403 (rupture d’authentification) mais généralement pas 404 (erreurs client). Le 429 (limite de taux) mérite une alerte si votre moniteur est lui-même ralenti. Combinez avec des assertions sur la charge utile pour détecter le cas 200-mais-cassé.
Configurez le moniteur pour demander la page 1 et vérifiez le champ total-count ainsi que la présence des métadonnées next-page. Pour une validation complète sur les pages, construisez une chaîne multi-étapes qui suit le lien next et valide chaque page via le curseur.
JSONPath est un langage de requête pour JSON, analogue à XPath pour XML. Il vous permet d’assertionner des champs spécifiques profondément à l’intérieur d’une charge utile sans analyser tout le corps. Exemple : $.order.status == “confirmed” ou $.items.length > 0.
Oui. Configurez la clé d’accès AWS et le secret dans le Coffre-fort Sécurisé; Dotcom-Monitor gère automatiquement la signature SigV4 des requêtes selon les spécifications AWS.
Vous surveillez plus que REST ? Découvrez la plateforme complète de surveillance API →
Essai gratuit de 30 jours. Sans carte de crédit. Accès complet à la plateforme. En direct en moins de cinq minutes.