
Organisations dans le monde entier
SLA de disponibilité de la plateforme
Emplacements mondiaux de surveillance
Leader de la surveillance de sites web
La surveillance des API est la pratique continue et automatisée de validation des points de terminaison API pour la disponibilité, le temps de réponse et la correction des données — en exécutant des requêtes synthétiques depuis l’extérieur de votre infrastructure et en alertant votre équipe dès qu’une de ces requêtes échoue. Contrairement aux tests ponctuels, la surveillance fonctionne 24/7 selon un rythme fixe depuis plusieurs emplacements mondiaux.
Chaque protocole possède sa propre page détaillée avec des guides d’installation, des exemples de code et des cas d’utilisation. Ou commencez simplement un essai et nous détecterons automatiquement ce que vous utilisez.
Validation JSON, assertions de schéma, chaînage multi-étapes, OAuth/JWT. Le pilier de toute équipe utilisant des API HTTP REST.
Import WSDL, validation XPath, prise en charge SOAP 1.1/1.2, WS-Security. Conçu pour les API d’entreprise, financières et de santé.
Surveillance consciente des requêtes. Inspecte le tableau errors et les données de réponse, car GraphQL retourne 200 même en cas d’échec.
Importez les exports Insomnia v4 avec tous les détails de requête, variables d’environnement et configurations d’authentification préservés.
Vous cherchez OAuth, JWT, mTLS ou d’autres protocoles d’authentification ? Tous les protocoles ci-dessus les supportent — voir la matrice complète d’authentification →
Références externes : en savoir plus sur REST, SOAP, GraphQL, et le modèle API lui-même.
Six choses que les équipes nous disent ne pas pouvoir faire aussi bien avec Datadog, Pingdom, Uptrends ou Postman Monitors.
Réalisez des contrôles distribués depuis l’Amérique du Nord, l’Europe, l’Asie-Pacifique et l’Amérique du Sud. Repérez les problèmes régionaux de CDN, les délais de propagation DNS, les erreurs de géoroutage.
Disponibilité contractuelle soutenue par plus de 25 ans d’infrastructure de surveillance. Votre outil de surveillance lui-même ne devient jamais le point de défaillance unique.
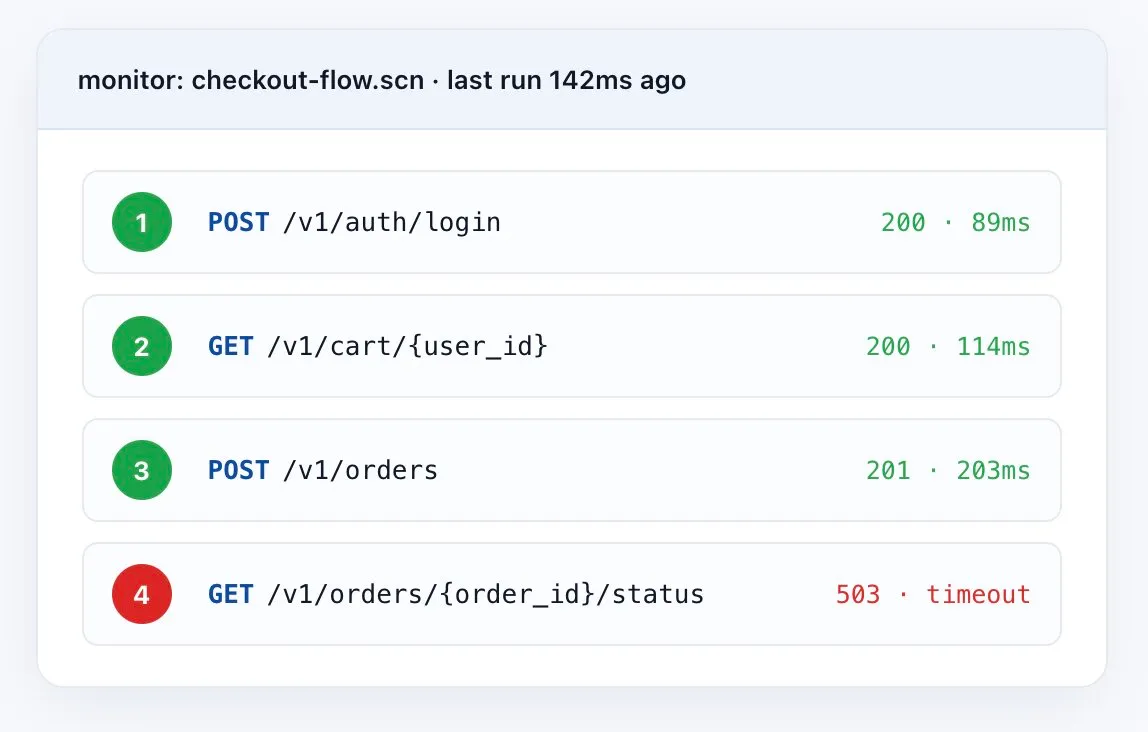
Connexion en chaîne → récupération → mutation → confirmation dans un seul moniteur. Passez des jetons entre les étapes, annulez à la première erreur, capturez les journaux au niveau des étapes.
Dirigez les alertes directement vers vos outils d’incidents — avec contexte diagnostic, charges de réponse et IDs de trace dans la première notification.
Déposez un agent léger dans votre VPC pour surveiller les microservices internes. Connexion sortante uniquement — aucune règle de pare-feu entrante.
Déclenchez des exécutions de moniteurs depuis GitHub Actions, Jenkins, Azure DevOps. Conditionnez les versions aux résultats d’assertion, latence ou disponibilité.
Un contrôle /health qui fonctionne ne prouve pas que votre logique métier fonctionne encore. Chaînez de vraies séquences — auth → récupération → mutation → vérification — et validez chaque étape. Au moment où la chaîne se brise, vous savez exactement où, pourquoi, et à quoi ressemblait la réponse.
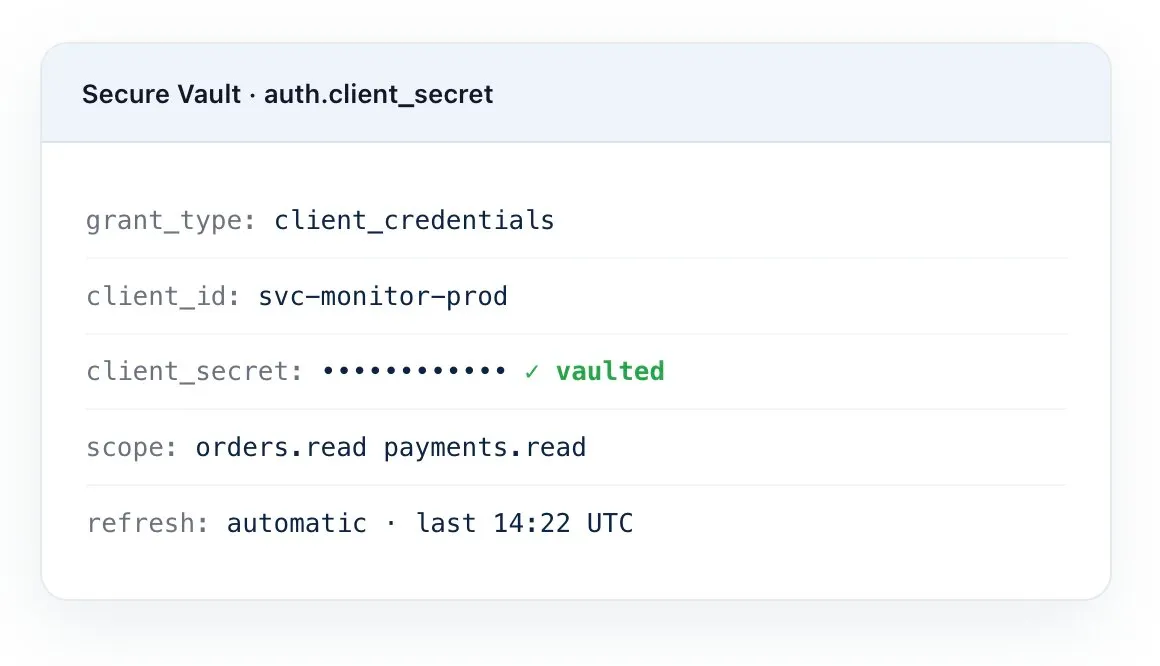
Les APIs de production ne vivent pas derrière une seule méthode d’authentification. Dotcom-Monitor prend en charge nativement toute la gamme — et masque chaque secret dans Secure Vault, ainsi les identifiants ne fuient jamais dans les journaux ou scripts exportés.
Dotcom-Monitor exploite sa propre infrastructure de surveillance dans plus de 30 emplacements sur six continents — plus des Agents Privés que vous pouvez déployer dans votre VPC, derrière des firewalls ou sur site pour surveiller les microservices internes.
Cela signifie que vous détectez la panne régionale, le délai de propagation DNS, la mauvaise route CDN — pas seulement les pannes globales.
Emplacements mondiaux
Continents couverts
Intervalle minimum de contrôle
Pour les environnements derrière un firewall

Configurez les points de terminaison REST, SOAP ou GraphQL, les en-têtes, les assertions JSONPath/XPath et l’authentification. Ou importez directement une collection Postman ou Insomnia.
Exécutez les contrôles à des intervalles de 1, 3, 5 ou 15 minutes depuis plus de 30 emplacements mondiaux en Amérique du Nord, en Europe, en Asie-Pacifique et en Amérique du Sud.
Suivez le pourcentage de disponibilité, les temps de réponse P95/P99, le TTFB, le temps DNS et les taux d’erreur par code de statut HTTP sur chaque point de terminaison surveillé.
Recevez des alertes par e-mail, SMS, Slack, PagerDuty ou Teams en quelques secondes — avec le temps de réponse, le code d’état et les échecs de validation joints.
Les API alimentent les paiements, l’authentification, les stocks, les transactions financières et les intégrations SaaS. Lorsqu’elles échouent — même brièvement — l’impact est immédiat.
Sans surveillance proactive, les équipes dépendent des rapports clients pour détecter les défaillances — ajoutant 30 à 60 minutes rien que pour la détection. La surveillance synthétique continue réduit la détection à moins de 60 secondes, permettant une isolation plus rapide de la cause racine.
Pour les SaaS B2B, FinTech et soins de santé, les interruptions d’API entraînent des pénalités SLA, des violations de conformité et des constats d’audit. Des preuves documentées de disponibilité défendent le respect du SLA lors des discussions de renouvellement.
Une plateforme e-commerce traitant 100 commandes/min à 50 $/commande perd 25 000 $ par interruption de 5 minutes. Un échec lors du passage en caisse, de l’autorisation de paiement ou de l’appel d’authentification arrête immédiatement la conversion.
Les applications modernes dépendent de Stripe, Auth0, Okta, Twilio. Même lorsque votre infrastructure est saine, un flux en amont dégradé peut casser le processus de paiement, la connexion et la synchronisation des données. Surveillez les points de terminaison tiers pour isoler l’origine des pannes.
Un ingénieur en performance vous montrera comment configurer votre premier moniteur dans votre environnement — pas de discours commercial, seulement un moniteur fonctionnel à la fin de l’appel. Réservation directe via le calendrier, sans intermédiation.
Une référence pour les acheteurs qui comparent les options. Nous essayons d’être équitables — chaque outil a une fonction ; voici où nous nous situons.
Capacité | Dotcom-Monitor | Postman Monitors | Pingdom / Uptime uniquement | Datadog Synthetics |
|---|---|---|---|---|
Chaînes API multi-étapes avec passage de variables | Complet | Partiel | ||
Assertions de charge utile JSON / XML / XPath | Limité | |||
OAuth 2.0 + actualisation automatique JWT | Manuel | Limité | ||
SOAP / WSDL / WS-Security | Partiel | |||
Agents privés (derrière un pare-feu) | ||||
30+ emplacements de surveillance mondiaux | Limité | |||
Importer des collections Postman / Insomnia | (Postman) | |||
Blocage CI/CD via API | Partiel | |||
Essai gratuit | 30 jours, toutes fonctionnalités | Plans payants | 14 jours | 14 jours |
A créé un moniteur complet de flux de paiement avec EveryStep Recorder qui fonctionne toutes les 15 minutes — ajoute des articles, applique des coupons, valide les prix, soumet avec une carte rejetée pour tester la logique de paiement de bout en bout.
Des millions de visiteurs mensuels dans plus de 50 pays. Mise en œuvre du test synthétique + performance Dotcom-Monitor pour protéger le processus de paiement sous forte charge.
4.5
83 avis
4.6
4.6
Tous les avis proviennent de avis vérifiés Capterra. Notes au octobre 2026.
Chaque plan comprend la surveillance des API REST, des contrôles synthétiques, des transactions multi-étapes, et des rapports de disponibilité. Pas de frais cachés.
Gratuit
Gratuit à vie
0 $
Le plus populaire
Abonnements
À partir de
19 $
.99 /mo
Entreprise
Tarification personnalisée
Contactez-nous
Surveillez les dépendances API internes et tierces pour garantir que les intégrations retournent des données correctes à temps. Détectez la dégradation des API partenaires avant qu’elle ne se propage.
Suivez les passerelles de paiement (Stripe, PayPal), les systèmes d’inventaire et les points de livraison. Une panne de 5 minutes au moment du paiement peut coûter des dizaines de milliers pendant les pics.
Assurez-vous que les API financières respectent les normes réglementaires de sécurité et une latence inférieure à la seconde. Surveillez le traitement des transactions, la KYC et les intégrations bancaires pour éviter les échecs de transactions.
Surveillez les API DSE, les portails d’assurance et les plateformes de télémédecine. Maintenez les points d’échange de données conformes à la HIPAA disponibles et réactifs.
Validez les intégrations API inter-départements — CRM, ERP, RH, communications. Détectez les pannes inter-systèmes avant qu’elles ne perturbent les flux de travail internes.
Surveillez les API de livraison de contenu, les points de diffusion et les services de gestion des droits. Vérifiez que les consommateurs en aval voient les données correctes à l’échelle mondiale.
Sept actions que toute équipe gérant des API en production devrait faire — quel que soit l’outil choisi.
Un seul emplacement ne peut pas détecter les pannes régionales de DNS, les mauvaises configurations CDN, ou les problèmes de routage géographique. Utilisez au moins 5 emplacements distribués.
Un HTTP 200 ne garantit pas l’exactitude. Utilisez des assertions JSONPath ou XPath pour vérifier que les corps de réponse ont la structure et le contenu attendus.
Les seuils statiques déclenchent des faux positifs. Établissez des références par point de terminaison, puis alertez à 2× le temps de réponse P95.
L’expiration des jetons, les échecs de rafraîchissement OAuth et la rotation de certificats sont des causes courantes de pannes. Incluez les étapes d’authentification pour détecter rapidement les problèmes de crédential.
Un seul point de terminaison peut réussir tandis que la transaction complète échoue. Les moniteurs multi-étapes détectent les échecs de session, de séquençage et de dépendance aux données.
Les passerelles de paiement, les fournisseurs d’identité et les API d’expédition se dégradent de façon indépendante. Des moniteurs dédiés isolent si les défaillances sont internes ou externes.
Exécutez des vérifications synthétiques post-déploiement. Les tests automatiques détectent les changements de schéma, les champs manquants et les régressions avant qu’ils n’atteignent les utilisateurs.
La surveillance des API est la pratique continue et automatisée de validation des points de terminaison d’API pour la disponibilité, le temps de réponse et la correction des données depuis l’extérieur de votre infrastructure. Contrairement aux tests ponctuels, la surveillance fonctionne 24h/24 et 7j/7 depuis plusieurs emplacements mondiaux selon un calendrier fixe — et vous alerte dès que l’un d’eux échoue.
Clé API, Authentification Basic, OAuth 2.0 (Client Credentials, Authorization Code, Refresh Token), JWT avec rafraîchissement automatique, Token Bearer, AWS Signature v4, NTLM, Kerberos, mTLS et en-têtes personnalisés. Les secrets sont masqués via le Secure Vault.
Oui. Les moniteurs multi-étapes transmettent les jetons, identifiants et valeurs dynamiques entre les étapes, valident chaque étape indépendamment, et arrêtent la chaîne dès la première erreur avec des journaux complets de requêtes/réponses par étape.
Oui. Déployez des Agents Privés légers à l’intérieur de votre réseau — ils initient des connexions sortantes, donc aucune règle de pare-feu entrante n’est nécessaire.
Les outils de disponibilité vous affichent vert lorsqu’un code 200 est reçu. Nous validons la réponse réelle — schéma JSON, en-têtes, contenu de la charge utile, percentiles de latence, succès des chaînes en aval — ainsi les échecs partiels (le type 200-mais-cassé) sont détectés.
La surveillance API teste depuis l’extérieur (du point de vue de l’utilisateur). L’APM suit le comportement interne — code, base de données, serveur. Les équipes mûres utilisent les deux : synthétique pour les contrôles côté client, APM pour le débogage des causes profondes.
Oui. Déclenchez les exécutions de moniteurs via API depuis GitHub Actions, Jenkins, Azure DevOps. Conditionnez le déploiement à la disponibilité, à la latence ou aux résultats d’assertions pour empêcher les mauvaises versions d’atteindre la production.
Aussi souvent qu’une fois par minute et par point de terminaison. Nous recommandons des intervalles d’1 minute pour les parcours critiques (connexion, paiement, validation) et des intervalles de 5 ou 15 minutes pour les points de terminaison moins prioritaires.
Pourcentage de disponibilité (objectif 99,9 %+), temps de réponse (P95/P99), taux d’erreur (4xx + 5xx), TTFB, temps de résolution DNS, temps de négociation SSL et débit. Plus la validation de la charge utile — métrique totalement ignorée par les outils de disponibilité.
Pour les API impactant le chiffre d’affaires (connexion, paiement, validation), chaque minute. Pour les points de terminaison moins critiques, toutes les 5 ou 15 minutes conviennent. Le bon rythme équilibre le temps de détection et le coût du volume de vérifications.
Les tests ont lieu en développement et en CI pour vérifier que les points de terminaison fonctionnent correctement avant la mise en production. La surveillance s’exécute en continu en production, suivant la disponibilité réelle, la latence et la précision des réponses dans le temps. Les tests détectent les bugs avant le déploiement; la surveillance détecte les pannes, régressions et dégradations après le déploiement.
Non. La surveillance API teste de l’extérieur (le point de vue de l’utilisateur). L’APM suit le comportement interne — exécution du code, requêtes de base de données, ressources serveur. Les équipes matures utilisent les deux : synthétique pour les contrôles orientés client, APM pour le débogage des causes profondes.
Le Time to First Byte mesure le temps écoulé entre l’envoi d’une requête et la réception du premier octet de la réponse. Pour un client synthétique, cela inclut DNS, TCP, TLS et le traitement serveur — mais pas le temps de transfert du corps. Un temps de réponse élevé avec un TTFB faible indique une charge utile importante ; un TTFB élevé indique un traitement serveur lent.
Pour les applications globales, au moins 5 sites répartis couvrant vos principales régions d’utilisateurs. Base typique : Amérique du Nord Est, Amérique du Nord Ouest, Europe de l’Ouest, Asie-Pacifique, Amérique du Sud. Cela permet de détecter les problèmes régionaux de CDN, les lacunes de propagation DNS et les anomalies de géo-routage que la surveillance sur un site unique manque complètement.
Essai gratuit de 30 jours. Pas de carte de crédit. Accès complet à la plateforme. Mise en service en moins de cinq minutes.