Organizaciones en todo el mundo
SLA de tiempo de actividad de la plataforma
Ubicaciones globales de monitoreo
Líder en monitoreo de sitios web
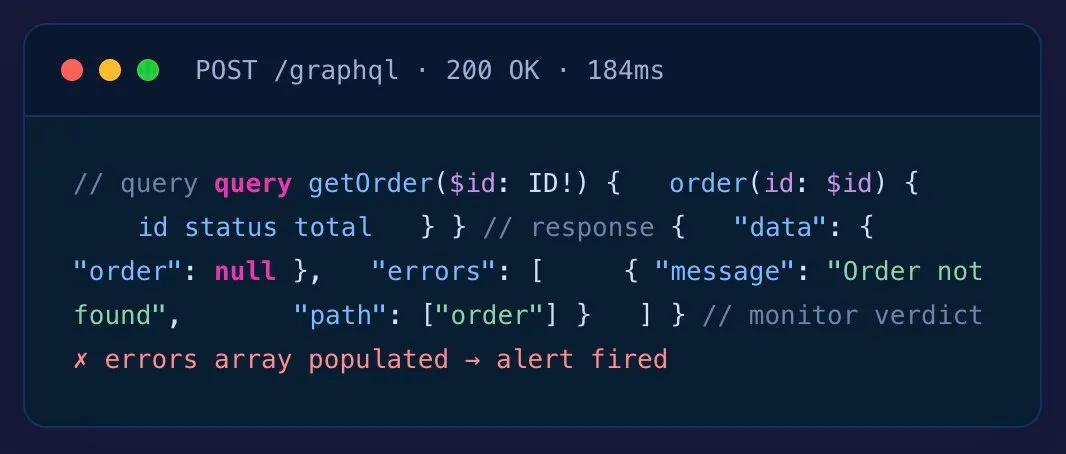
El monitoreo de API GraphQL es la prueba consciente de consultas de los endpoints GraphQL desde fuera de tu infraestructura — inspeccionando el array errors y la forma de data del cuerpo de la respuesta (ya que el estado HTTP usualmente es 200 incluso cuando hay fallos), rastreando la latencia de la consulta y alertando cuando ocurren fallas.
La gran ventaja de GraphQL — un endpoint, consultas flexibles — es también por qué el monitoreo solo de disponibilidad te engaña. El modo de fallo que importa vive en el cuerpo de la respuesta, no en el código de estado.
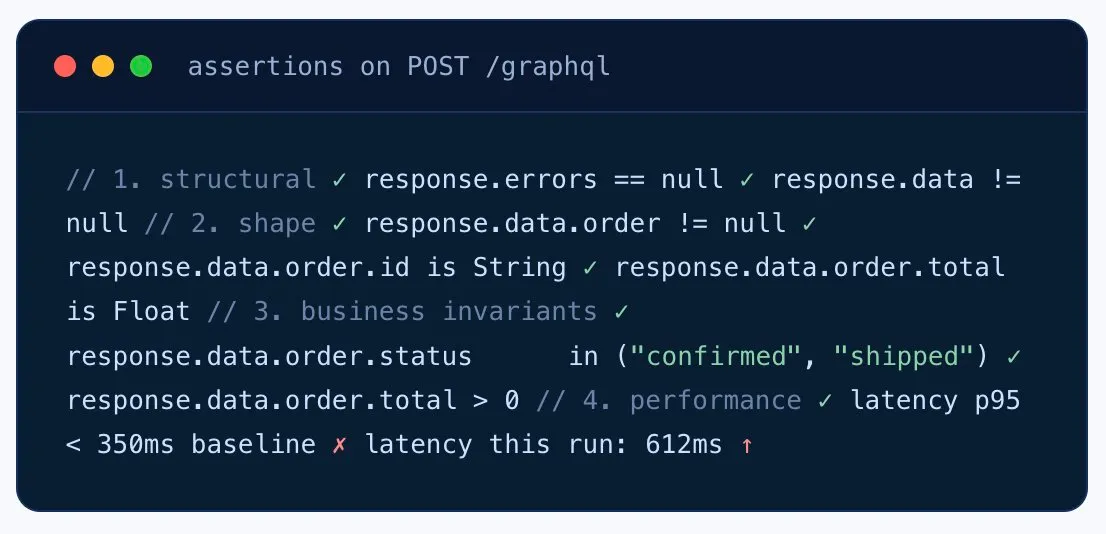
Envía una consulta definida, luego verifica el cuerpo de la respuesta. Cada monitor sabe si apareció el array errors, si data contiene la estructura esperada, y si las invariantes comerciales se mantienen.
errors[].length > 0.
data para detectar campos nulos o claves faltantes.
data.order.status == "confirmed".
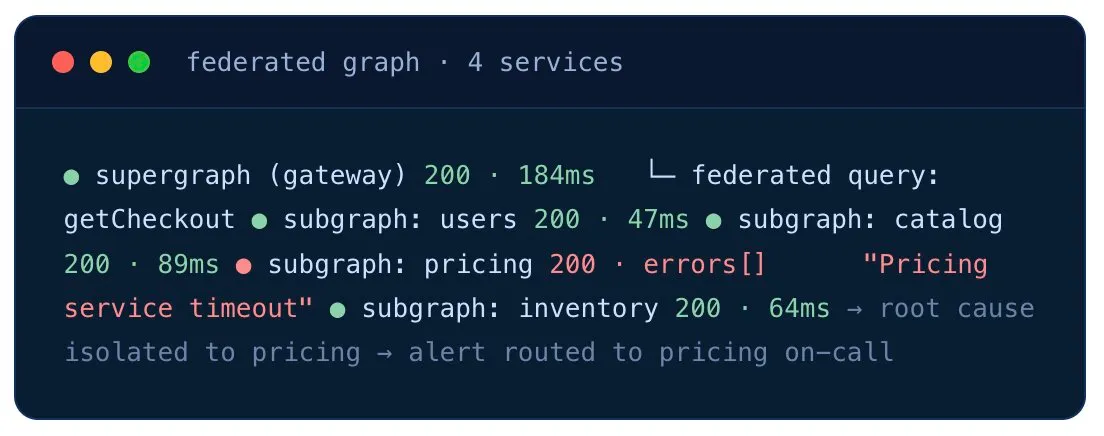
Una configuración federada de GraphQL oculta fallos de servicios descendentes detrás del gateway. Monitorea el supergrafo para detectar fallos visibles para el cliente — y los subgráficos individuales para identificar cuál servicio es el culpable.
El único endpoint GraphQL del que depende tu aplicación móvil. Detecta la falla parcial silenciosa que devuelve 200-con-errores y muestra una pantalla en blanco a los usuarios.
Supergraph + subgraphs monitoreados por separado. Cuando la consulta federada falla, los monitores de subgraph te indican qué servicio descendente activar.
placeOrder, processPayment, submitClaim — las mutaciones que mueven dinero o estado. Monitorea cada una individualmente, asegurando las invariantes de datos.
Ejecuta el monitor desde CI después de cada despliegue. Detecta el cambio de esquema que silenciosamente anula un campo, o el cambio de nombre del resolver que rompe la aplicación móvil.
Seguimiento de latencia P95/P99 por consulta. Detecta si el resolver costoso supera la línea base antes de que las reseñas de la aplicación móvil caigan.
Para suscripciones GraphQL basadas en WebSocket, verifica que la conexión se establezca, reciba mensajes y se mantenga activa — usando nuestro monitoreo WebSocket.
Un ingeniero de rendimiento te guiará a través de la monitorización de GraphQL con detección de array de errores y enrutamiento federado — sin presentación comercial, solo un monitor funcional al final de la llamada.
Más de 30 ubicaciones de monitoreo propias en seis continentes. Detecta el problema regional del CDN o la falla de enrutamiento en la puerta de enlace edge que las pruebas locales no ven.
Para servicios internos BFF GraphQL y gráficos solo backend, despliega un Agente Privado dentro de tu VPC — misma profundidad de monitoreo, sin reglas de firewall de entrada.
Ubicaciones globales de monitoreo
Continentes cubiertos
Intervalo mínimo de verificación
Para uso detrás del cortafuegos

4.5
83 reseñas
4.6
4.6
Todas las reseñas provienen de reseñas verificadas de Capterra. Clasificaciones a fecha de agosto 2026.
¿Quieres probar sin compromiso? Plan Gratis Para Siempre disponible — hasta 25 objetivos, 2 ubicaciones de monitoreo, 7 días de retención de datos. Comienza gratis → o Comparar planes
La mayoría de las implementaciones de GraphQL devuelven HTTP 200 incluso cuando la consulta falla. Los fallos residen dentro del cuerpo de la respuesta — en el arreglo errors, o como nulos dentro del objeto data — no en el código de estado. El monitoreo solo de tiempo activo marca las APIs GraphQL con fallos como saludables. El monitoreo real de GraphQL debe inspeccionar la carga útil de la respuesta. Ver monitoreo de API REST →
Envía una carga útil de consulta específica y luego realiza aserciones contra el cuerpo de la respuesta. Verifica si el arreglo errors de nivel superior está presente o poblado, valida invariantes de datos específicos de la consulta en la respuesta y marca nulos en campos que no pueden ser nulos. Algunos servidores GraphQL codifican fallos de dominio dentro del objeto data en lugar de poblar errores — se revisan ambas señales.
Sí. Cada monitor ejecuta una carga útil de consulta o mutación definida. Monitorea tus mutaciones más críticas (placeOrder, processPayment) individualmente para rastrear la latencia por operación, tasa de errores y tasa de fallos parciales.
Todos los esquemas comunes de autenticación: Bearer Token (el más común para GraphQL), OAuth 2.0 con renovación automática, JWT, Clave API, Autenticación Básica, Firma AWS v4, mTLS y encabezados personalizados. Los secretos se ocultan mediante Secure Vault. Ver matriz de autenticación →
Sí. Monitorea el endpoint supergraph para verificar que el gateway de federación esté saludable y monitorea endpoints individuales de subgraph para aislar qué servicio falla cuando una consulta federada falla. Funciona con Apollo Federation y arquitecturas similares.
Se rastrea la latencia total de la consulta, con percentiles P95/P99 por consulta. Para identificar resolutores lentos individuales, combina el monitoreo con tu trazado APM — el monitoreo sintético confirma la lentitud visible para el cliente; APM confirma qué resolutor es el cuello de botella.
Sí. Despliega Agentes Privados dentro de tu VPC o centro de datos — común para servicios GraphQL backend-for-frontend (BFF) que no están expuestos públicamente.
El monitoreo puede incluir consultas en varios niveles de profundidad y complejidad para verificar que tus límites de limitación y complejidad se apliquen. Combínalo con tu WAF o middleware de complejidad de consulta para protección total.
Las suscripciones de GraphQL suelen usar WebSocket — vea nuestro monitoreo WebSocket para el establecimiento de la conexión, entrega de mensajes y chequeos de keepalive.
Monitoree el endpoint supergraph para verificar que la puerta de enlace de federación esté saludable Y monitoree los endpoints individuales de subgraph por separado para aislar qué servicio aguas abajo falla cuando una consulta federada se rompe. Ambos monitores comparten rutas de alerta para una respuesta consolidada a incidentes.
Las suscripciones de GraphQL usan transporte WebSocket. Use nuestro producto de monitoreo WebSocket para validar que la conexión de suscripción se establezca correctamente, reciba los eventos esperados y se mantenga activa durante sesiones de larga duración.
Sí. Configure identificadores de consultas persistentes (Apollo Persisted Queries o hashes estilo Relay) en la solicitud y Dotcom-Monitor los enviará como referencia de operación en lugar de la cadena completa de consulta.
Construya monitores con profundidad y complejidad de consulta crecientes para verificar que su middleware de límite de complejidad aplique correctamente el umbral. Combine la configuración del monitor con sus reglas de complejidad del servidor GraphQL.
¿Monitoreando más que GraphQL? Vea la plataforma completa de Monitoreo API →
Prueba gratuita de 30 días. Sin tarjeta de crédito. Monitoreo consciente de la carga útil desde más de 30 ubicaciones globales.