
Organisationen weltweit
Plattform-Uptime-SLA
Globale Überwachungsstandorte
Marktführer bei der Website-Überwachung
API-Überwachung ist die kontinuierliche, automatisierte Praxis der Validierung von API-Endpunkten auf Verfügbarkeit, Reaktionszeit und Datenkorrektheit — es werden synthetische Anfragen von außerhalb Ihrer Infrastruktur ausgeführt und Ihr Team wird sofort benachrichtigt, sobald eine davon ausfällt. Im Gegensatz zu einmaligen Tests läuft die Überwachung rund um die Uhr in festgelegten Abständen von mehreren globalen Standorten.
Jedes Protokoll verfügt über eine eigene Detailseite mit Einrichtungsanleitungen, Codebeispielen und Anwendungsfällen. Oder starten Sie einfach eine Testphase, und wir erkennen automatisch, was Sie verwenden.
JSON-Validierung, Schema-Assertions, mehrstufige Verkettung, OAuth/JWT. Das Arbeitspferd für jedes Team, das HTTP REST APIs betreibt.
WSDL-Import, XPath-Validierung, SOAP 1.1/1.2-Unterstützung, WS-Security. Entwickelt für Enterprise-, Finanz- und Gesundheits-APIs.
Abfragebewusste Überwachung. Prüft das errors-Array und die Antwortdaten, da GraphQL bei Fehlern trotzdem 200 zurückgibt.
Importieren Sie Insomnia v4 Exporte mit vollständigen Anfragedetails, Umgebungsvariablen und Auth-Konfigurationen.
Suchen Sie OAuth, JWT, mTLS oder andere Auth-Schemata? Jedes oben genannte Protokoll unterstützt sie — sehen Sie die vollständige Auth-Matrix →
Externe Verweise: Erfahren Sie mehr über REST, SOAP, GraphQL und das API-Muster selbst.
Sechs Dinge, die uns Teams sagen, dass sie mit Datadog, Pingdom, Uptrends oder Postman Monitors nicht so sauber erledigen konnten.
Führen Sie verteilte Prüfungen aus Nordamerika, Europa, Asien-Pazifik und Südamerika durch. Erkennen Sie das regionale CDN-Problem, die DNS-Propagation-Lücke, den Geo-Routing-Fehler.
Vertraglich garantierte Verfügbarkeit, unterstützt durch mehr als 25 Jahre Monitoring-Infrastruktur. Ihr Überwachungstool selbst wird niemals zum Single Point of Failure.
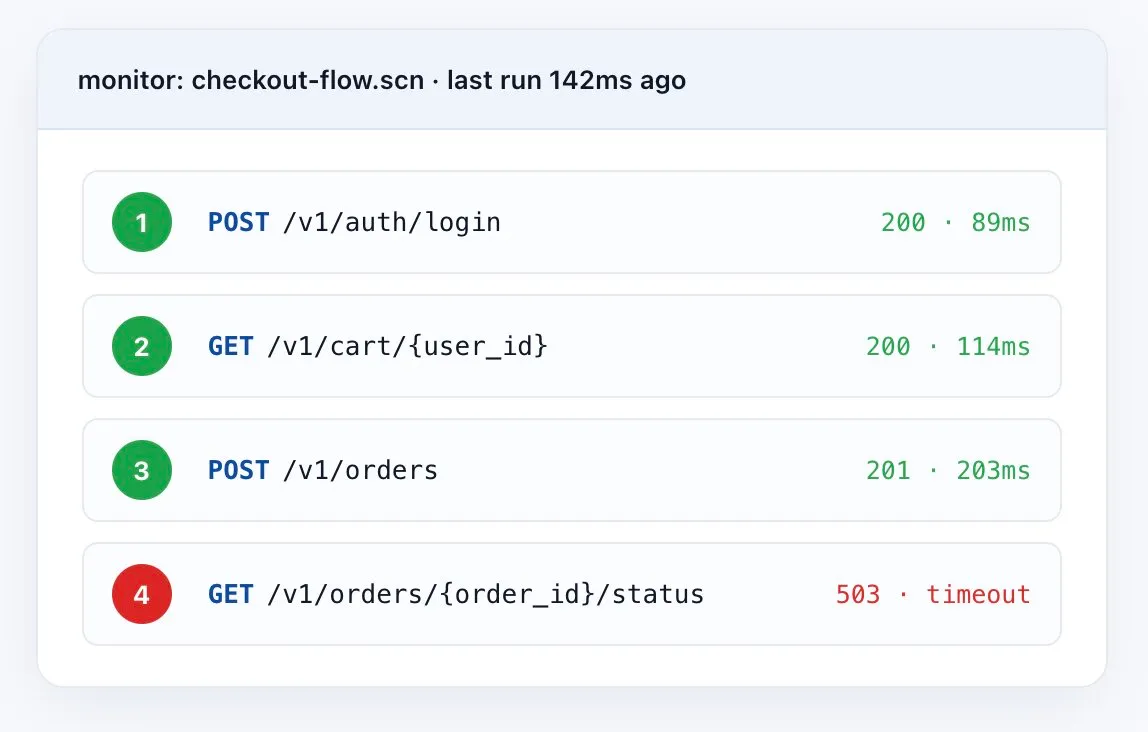
Ketten-Anmeldung → abrufen → ändern → bestätigen in einem Monitor. Tokens zwischen den Schritten weitergeben, beim ersten Fehler abbrechen, Schritt-für-Schritt-Protokolle erfassen.
Leiten Sie Warnungen direkt in Ihre Incident-Tools — mit Diagnosekontext, Antwortdaten und Trace-IDs in der ersten Benachrichtigung.
Setzen Sie einen leichtgewichtigen Agent in Ihrem VPC ein, um interne Microservices zu überwachen. Nur ausgehende Verbindungen — keine eingehenden Firewall-Regeln.
Lösen Sie Monitorläufe aus GitHub Actions, Jenkins, Azure DevOps aus. Freigaben basierend auf Assertionsergebnissen, Latenz oder Verfügbarkeit steuern.
Eine funktionierende /health-Prüfung beweist nicht, dass Ihre Geschäftslogik noch funktioniert. Verketten Sie echte Abläufe — Auth → Abrufen → Ändern → Verifizieren — und validieren Sie jeden Schritt. Sobald die Kette unterbrochen ist, wissen Sie genau, wo, warum und wie die Antwort aussah.
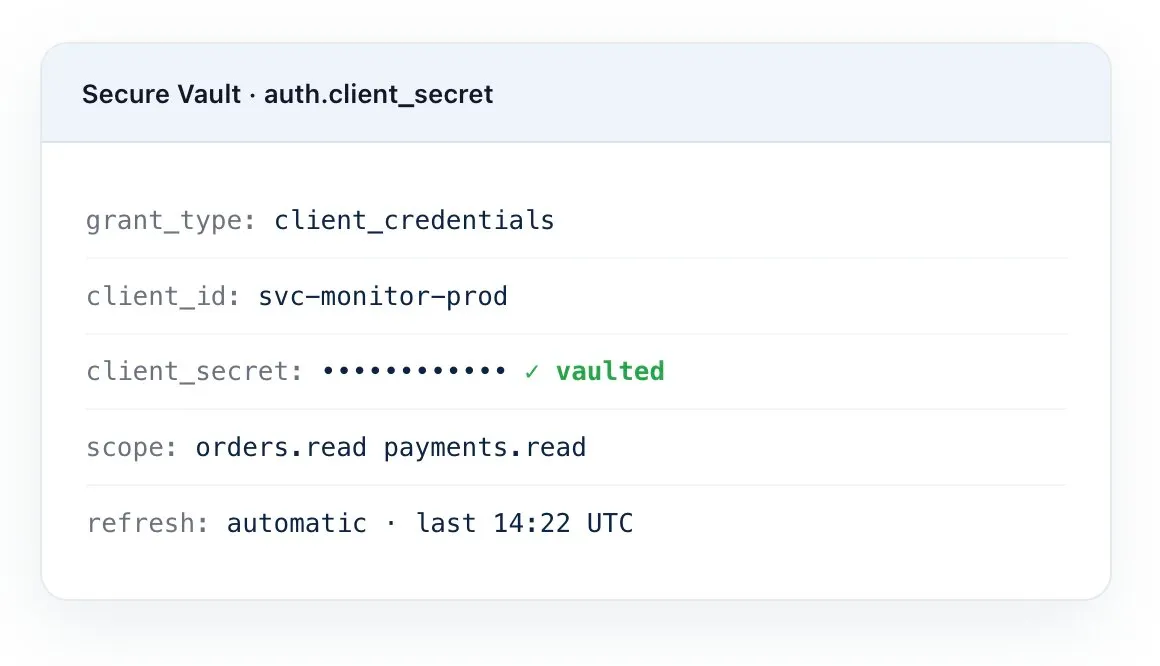
Produktions-APIs verwenden nicht nur eine Auth-Methode. Dotcom-Monitor unterstützt nativ das gesamte Spektrum — und maskiert jedes Geheimnis im Secure Vault, sodass Anmeldeinformationen nie in Protokollen oder exportierten Skripten auftauchen.
Dotcom-Monitor betreibt seine eigene Überwachungsinfrastruktur an über 30 Standorten auf sechs Kontinenten – plus Private Agents, die Sie innerhalb Ihres VPC, hinter Firewalls oder lokal einsetzen können, um interne Microservices zu überwachen.
Das bedeutet, Sie erkennen regionale Ausfälle, DNS-Propagation-Probleme, CDN-Fehlleitungen – nicht nur globale.
Globale Standorte
Abgedeckte Kontinente
Mindestüberprüfungsintervall
Für den Betrieb hinter Firewalls

Konfigurieren Sie REST-, SOAP- oder GraphQL-Endpunkte, Header, JSONPath-/XPath-Assertionen und Authentifizierung. Oder importieren Sie direkt eine Postman- oder Insomnia-Sammlung.
Führen Sie Überprüfungen in Intervallen von 1, 3, 5 oder 15 Minuten von über 30 globalen Standorten in Nordamerika, Europa, Asien-Pazifik und Südamerika durch.
Verfolgen Sie die Verfügbarkeitsrate %, P95/P99 Antwortzeiten, TTFB, DNS-Zeit und Fehlerraten nach HTTP-Statuscode über alle überwachten Endpunkte hinweg.
Erhalten Sie innerhalb von Sekunden Benachrichtigungen per E-Mail, SMS, Slack, PagerDuty oder Teams – mit Antwortzeit, Statuscode und Validierungsfehlern.
APIs steuern Zahlungen, Authentifizierung, Inventar, Finanztransaktionen und SaaS-Integrationen. Wenn sie ausfallen – selbst kurzfristig – ist die Auswirkung sofort spürbar.
Ohne proaktive Überwachung verlassen sich Teams auf Kundenmeldungen zur Fehlererkennung – was allein 30–60 Minuten zur Erkennung hinzufügt. Kontinuierliche synthetische Überwachung verkürzt die Erkennung auf unter 60 Sekunden und ermöglicht eine schnellere Ursachenanalyse.
Für B2B SaaS, FinTech und Gesundheitswesen führen API-Ausfälle zu SLA-Strafen, Compliance-Verstößen und Prüfungsfeststellungen. Dokumentierte Verfügbarkeitsnachweise sind der Schutz für die Einhaltung von SLAs bei Verlängerungsgesprächen.
Eine E-Commerce-Plattform, die 100 Bestellungen/Min bei 50 $/Bestellung verarbeitet, verliert 25.000 $ pro 5-minütigem Ausfall. Ein fehlgeschlagener Checkout, Zahlungsautorisierung oder Auth-Aufruf stoppt die Conversion sofort.
Moderne Apps sind auf Stripe, Auth0, Okta, Twilio angewiesen. Selbst wenn Ihre Infrastruktur gesund ist, kann eine verschlechterte vorgelagerte Komponente den Checkout, das Login und die Datensynchronisation beeinträchtigen. Überwachen Sie Drittanbieter-Endpunkte, um Fehlerquellen zu isolieren.
Ein Performance-Ingenieur zeigt Ihnen, wie Sie ihren ersten Monitor in Ihrer Umgebung einrichten — kein Verkaufsgespräch, sondern ein funktionierender Monitor am Ende des Anrufs. Direkte Kalenderbuchung, kein Gatekeeping.
Eine Referenz für Käufer, die Optionen abwägen. Wir versuchen fair zu sein — jedes Tool hat seine Aufgabe; hier passen wir rein.
Fähigkeit | Dotcom-Monitor | Postman Monitors | Pingdom / Nur Uptime | Datadog Synthetics |
|---|---|---|---|---|
Mehrstufige API-Ketten mit Variablenübergabe | Vollständig | Teilweise | ||
JSON / XML / XPath Payload-Überprüfungen | Begrenzt | |||
OAuth 2.0 + JWT Auto-Refresh | Manuell | Begrenzt | ||
SOAP / WSDL / WS-Security | Teilweise | |||
Private Agenten (hinter Firewall) | ||||
30+ globale Überwachungsstandorte | Begrenzt | |||
Postman / Insomnia-Sammlungen importieren | (Postman) | |||
CI/CD-Gate-Blocking über API | Teilweise | |||
Kostenlose Testversion | 30 Tage, volle Funktionen | Bezahlte Pläne | 14 Tage | 14 Tage |
Erstellte einen vollständigen Checkout-Flow-Monitor mit EveryStep Recorder, der alle 15 Minuten läuft — fügt Artikel hinzu, wendet Gutscheine an, validiert Preise, sendet mit einer abgelehnten Karte, um die Zahlungslogik von Anfang bis Ende zu testen.
Millionen von monatlichen Besuchern aus über 50 Ländern. Implementierung von Dotcom-Monitor synthetischem + Performance-Testing zum Schutz des Checkouts bei Spitzenlast.
4.5
83 Bewertungen
4.6
4.6
Alle Bewertungen stammen von Capterra verifizierten Bewertungen. Bewertungen Stand August 2026.
Jeder Plan beinhaltet REST API-Überwachung, synthetische Checks, mehrstufige Transaktionen und Verfügbarkeitsberichte. Keine versteckten Gebühren.
Kostenlos
Für immer kostenlos
0 $
Am beliebtesten
Abonnements
Ab
19 $
.99 /Monat
Unternehmen
Individuelle Preisgestaltung
Lass uns reden
Überwachen Sie interne und Drittanbieter-API-Abhängigkeiten, um sicherzustellen, dass Integrationen korrekte Daten rechtzeitig zurückliefern. Erkennen Sie Partner-API-Verschlechterungen, bevor sie sich ausweiten.
Verfolgen Sie Zahlungsgateways (Stripe, PayPal), Inventarsysteme und Versandendpunkte. Ein 5-minütiger Ausfall beim Checkout kann während Spitzenzeiten Tausende kosten.
Stellen Sie sicher, dass Finanz-APIs gesetzliche Sicherheitsanforderungen und Sub-Sekunden-Latenzen erfüllen. Überwachen Sie die Transaktionsverarbeitung, KYC und Bankenintegrationen, um fehlgeschlagene Transaktionen zu vermeiden.
Überwachen Sie EHR-APIs, Versicherungsportale und Telemedizin-Plattformen. Halten Sie HIPAA-konforme Datenaustauschschnittstellen verfügbar und reagierend.
Validieren Sie abteilungsübergreifende API-Integrationen — CRM, ERP, HR, Kommunikation. Erkennen Sie Systemübergreifende Ausfälle, bevor sie interne Arbeitsabläufe stören.
Überwachen Sie Content-Delivery-APIs, Streaming-Endpunkte und Rechteverwaltungsdienste. Validieren Sie, dass nachgelagerte Nutzer global korrekte Daten sehen.
Sieben Dinge, die jedes Team, das produktive APIs betreibt, tun sollte — unabhängig vom verwendeten Tool.
Ein einzelner Standort kann regionale DNS-Ausfälle, CDN-Fehlkonfigurationen oder Geo-Routing-Probleme nicht erkennen. Nutzen Sie mindestens 5 verteilte Standorte.
Ein HTTP 200 garantiert keine Korrektheit. Verwenden Sie JSONPath- oder XPath-Assertions, um zu überprüfen, ob Antworttexte die erwartete Struktur und den Inhalt haben.
Statische Schwellenwerte lösen Fehlalarme aus. Legen Sie pro Endpunkt Baselines fest und alarmieren Sie bei dem 2-fachen der P95-Antwortzeit.
Tokenablauf, OAuth-Refresh-Fehler und Zertifikatsrotation sind häufige Ursachen für Ausfälle. Beziehen Sie Authentifizierungsschritte ein, damit Anmeldeprobleme früh erkannt werden.
Ein einzelner Endpunkt kann funktionieren, während die gesamte Transaktion fehlschlägt. Mehrschrittige Monitore erkennen Fehler bei Sitzungen, Reihenfolge und Datenabhängigkeiten.
Zahlungs-Gateways, Identitätsanbieter und Versand-APIs verschlechtern sich unabhängig voneinander. Dedizierte Monitore isolieren, ob Fehler intern oder extern verursacht werden.
Führen Sie nach der Bereitstellung synthetische Prüfungen durch. Automatisierte Smoke-Tests erkennen Schemaänderungen, fehlende Felder und Regressionen, bevor sie Benutzer erreichen.
API-Monitoring ist die kontinuierliche, automatisierte Praxis zur Validierung von API-Endpunkten hinsichtlich Verfügbarkeit, Antwortzeit und Datenkorrektheit von außerhalb Ihrer Infrastruktur. Im Gegensatz zu einmaligen Tests läuft das Monitoring 24/7 von mehreren globalen Standorten in festen Intervallen – und benachrichtigt Sie sofort, sobald einer davon ausfällt.
API-Schlüssel, Basic Auth, OAuth 2.0 (Client Credentials, Authorization Code, Refresh Token), JWT mit automatischer Aktualisierung, Bearer Token, AWS Signature v4, NTLM, Kerberos, mTLS und benutzerdefinierte Header. Geheimnisse werden durch den Secure Vault maskiert.
Ja. Mehrstufige Monitore übergeben Tokens, IDs und dynamische Werte zwischen den Schritten, validieren jeden Schritt unabhängig und brechen die Kette beim ersten Fehler ab, mit vollständigen Anfragen-/Antwortprotokollen pro Schritt.
Ja. Setzen Sie leichte Private Agents innerhalb Ihres Netzwerks ein – sie initiieren ausgehende Verbindungen, sodass keine eingehenden Firewallregeln erforderlich sind.
Uptime-Tools zeigen grün, wenn ein 200 zurückkommt. Wir validieren die tatsächliche Antwort – JSON-Schema, Header, Payload-Inhalte, Latenz-Perzentile, Erfolg der nachgeschalteten Kette – sodass Teilfehler (die Art 200-aber-defekt) erkannt werden.
API-Monitoring testet von außen (aus Sicht des Nutzers). APM verfolgt internes Verhalten – Code, Datenbank, Server. Erfahrene Teams verwenden beides: synthetisches Monitoring für kundenorientierte Checks, APM für Ursachenforschung bei Fehlern.
Ja. Starten Sie Monitorläufe via API aus GitHub Actions, Jenkins, Azure DevOps. Vorrangiges Ziel ist es, die Bereitstellung anhand von Verfügbarkeit, Latenz oder Assertion-Ergebnissen zu sperren, um fehlerhafte Builds am Erreichen der Produktion zu hindern.
So oft wie jede Minute pro Endpunkt. Wir empfehlen 1-Minuten-Intervalle für kritische Pfade (Login, Checkout, Zahlung) und 5- oder 15-Minuten-Intervalle für weniger wichtige Endpunkte.
Verfügbarkeits-% (Ziel 99,9%+), Antwortzeit (P95/P99), Fehlerquote (4xx + 5xx), TTFB, DNS-Auflösungszeit, SSL-Handshake-Zeit und Durchsatz. Plus Payload-Validierung – die Metrik, die Uptime-Tools komplett verpassen.
Für umsatzrelevante APIs (Login, Zahlung, Checkout) jede Minute. Für weniger kritische Endpunkte sind alle 5 oder 15 Minuten ausreichend. Der richtige Rhythmus balanciert Erkennungszeit gegen Kosten für die Prüfanfragen.
Tests erfolgen in Entwicklung und CI, um zu prüfen, ob Endpunkte vor der Freigabe korrekt funktionieren. Monitoring läuft kontinuierlich in der Produktion, verfolgt Verfügbarkeit, Latenz und Antwortgenauigkeit im laufenden Betrieb. Tests fangen Fehler vor dem Deployment ab; Monitoring erkennt Ausfälle, Regressionen und Verschlechterungen danach.
Nein. API-Überwachung testet von außen (aus Nutzersicht). APM verfolgt internes Verhalten – Code-Ausführung, Datenbankabfragen, Serverressourcen. Erfahrene Teams nutzen beides: synthetisch für kundenorientierte Prüfungen, APM für Ursachenanalyse.
Time to First Byte misst die verstrichene Zeit vom Senden einer Anfrage bis zum Empfang des ersten Bytes der Antwort. Vom synthetischen Client aus umfasst dies DNS, TCP, TLS und Serververarbeitung – aber nicht die Zeit zum Übertragen des Inhalts. Hohe Antwortzeit bei niedrigem TTFB weist auf eine große Nutzlast hin; hohes TTFB weist auf langsame Serververarbeitung hin.
Für globale Apps mindestens 5 verteilte Standorte, die Ihre wichtigsten Nutzerregionen abdecken. Typische Basis: Nordamerika Ost, Nordamerika West, Westeuropa, Asien-Pazifik, Südamerika. So werden regionale CDN-Probleme, DNS-Propagation-Lücken und Geo-Routing-Anomalien erkannt, die eine Überwachung an nur einem Standort völlig übersieht.
30 Tage kostenlos testen. Keine Kreditkarte. Volle Plattformzugänge. Start in unter fünf Minuten.