33
Locais de monitoramento
18
Países
6
Continentes
75 / 48
Nós em IPv4 / IPv6
Locais de monitoramento
Países
Continentes
Nós em IPv4 / IPv6
Nossa rede global de monitoramento é o conjunto de 33 locais de monitoramento de onde a Dotcom-Monitor executa verificações — 18 países, 6 continentes, cada um um nó de monitoramento em um data center comercial com seus próprios endereços IP publicados. Quando você configura um monitor, escolhe quais desses locais irão executá-lo. Cada local selecionado executa a verificação completa de forma independente e reporta seus próprios tempos, códigos de status e erros, então um problema que existe apenas em uma parte do mundo aparece como um problema naquela parte do mundo.
Os locais executam todos os tipos de verificação que a plataforma suporta: carregamentos de páginas com navegador real e transações multi-etapas EveryStep, chamadas de API REST, SOAP e GraphQL, e verificações em nível de protocolo como DNS, SSL, SMTP, FTP, porta TCP, ping e traceroute. Não há conjunto de recursos reduzido nas bordas — uma verificação em Sydney é a mesma verificação feita em Chicago.
Uma esclarecimento, porque os nomes são parecidos. Esta página é sobre de onde monitoramos: nossa própria infraestrutura e sua cobertura geográfica. Não se trata de monitorar a rede que você possui. Se o que você precisa são verificações de acessibilidade, latência, roteamento e perda de pacotes contra seus próprios hosts, roteadores e circuitos — monitoramento de ping, traceroute e porta TCP direcionado à sua infraestrutura — isso é monitoramento de rede, e tem sua própria página. Os dois trabalham juntos: monitoramento de rede é o que você verifica, a rede global de monitoramento é de onde você verifica.
Todos os 33 locais, agrupados por região. Cada um deles está disponível para todos os dispositivos de monitoramento na sua conta — não há um nível premium de locais “globais” reservado a planos superiores.
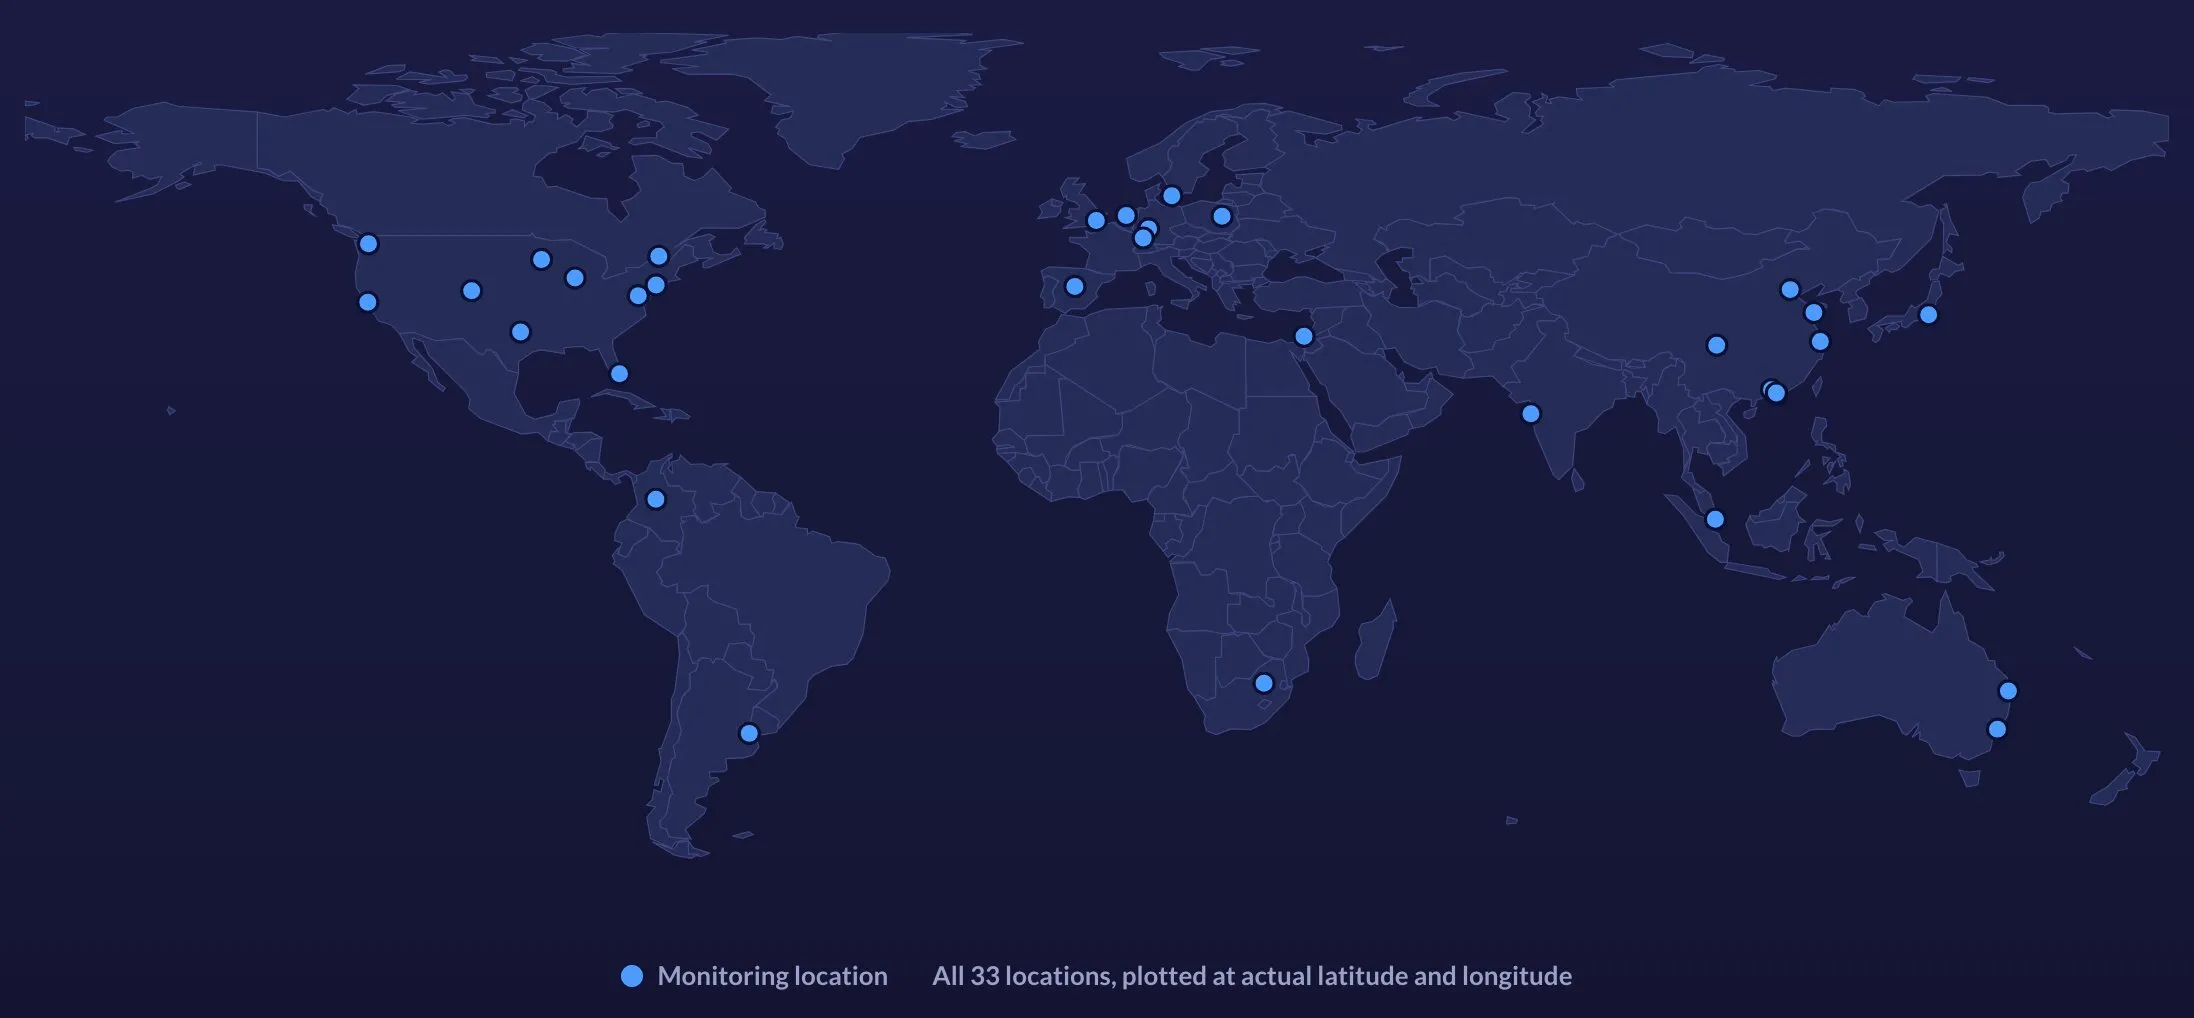
O mapa é um índice visual. A lista autoritária é o texto abaixo — e na sua conta, onde cada local aparece pelo nome na tela de configuração do dispositivo.
Precisa dos nossos IPs? A maioria das equipes quer eles por duas razões: filtrar tráfego sintético fora da sua análise e permitir que nossos agentes atravessem um WAF ou firewall. Os intervalos IPv4 e IPv6 atuais para cada local estão publicados e mantidos na base de conhecimento — veja o artigo endereços IP de localizações de monitoramento. Nós os mantemos propositalmente lá em vez de nesta página, porque os endereços mudam e esse artigo é a fonte verdadeira mantida. Esses endereços também permitem que você verifique nossa hospedagem por conta própria: pesquise qualquer um deles no whois ou RDAP e verá a rede e o provedor onde essa localização está.
Nas 33 localidades, operamos 75 nós de monitoramento em IPv4 e 48 em IPv6. Vinte e seis das 33 localidades respondem em ambos os protocolos, então a maior parte da rede é genuinamente dual-stack e não IPv4 com túnel. Sete localidades são apenas IPv4 — Buenos Aires, Varsóvia, Tel Aviv, Hong Kong, Qingdao, Tóquio e Cingapura — e um nó, em San Francisco, é IPv6-only, sem endereço IPv4 algum.
O nó IPv6-only é o que importa. Em um host dual-stack, um cliente que falha em IPv6 geralmente recua para IPv4 rápido o suficiente para que nada pareça quebrado — Happy Eyeballs esconde a falha por design. Então um probe dual-stack pode reportar um site saudável enquanto seus usuários somente IPv6 não conseguem acessá-lo. Um probe somente IPv6 não tem para onde recuar: se o registro AAAA estiver ausente, o registro apontar para o endereço errado, a regra do firewall foi escrita só para v4 ou o balanceador de carga nunca recebeu um listener v6, a checagem falha e você descobre.
Essa não é uma audiência teórica. Grandes operadoras móveis rodam redes de acesso IPv6-only com NAT64 na borda, e compras de empresas e governos em vários países exigem acessibilidade IPv6. Monitoramento single-stack nunca vê nada disso.
O que você pode testar | Onde ele roda | O que ele captura |
|---|---|---|
Checagens IPv4 | 75 nós em todas as 33 localidades | A linha de base que todo fornecedor cobre — acessibilidade, latência e roteamento via IPv4 de seis continentes. |
Checagens dual-stack | 48 nós IPv6 em 26 localidades | Diferenças de latência, roteamento e comportamento TLS entre os dois protocolos na mesma cidade. |
Checagens somente IPv6 | Um nó em San Francisco, sem endereço IPv4 | Registros AAAA ausentes ou errados, regras de firewall e WAF só para v4, balanceadores de carga sem listener v6 — falhas que o fallback IPv4 esconde em todo lugar. |
O endereço de cada nó é publicado: os endereços IPv6 para cada local ficam ao lado de seus endereços IPv4 no artigo endereços IP de local de monitoramento, de onde vêm as contagens de nós acima. Você pode contá-los você mesmo.
O monitoramento de local único responde a uma pergunta: o site está ativo para aquela máquina? Tudo abaixo é invisível para ele.
Regiões de nuvem, provedores de trânsito e peering IX falham regionalmente, não globalmente. Uma interrupção em eu-central afeta seus clientes europeus enquanto todas as verificações nos EUA permanecem verdes. Sem sondas europeias, seu primeiro sinal é um ticket de suporte.
Ambos são sistemas geográficos por design. Um cache de borda desatualizado, um PoP mal roteado ou uma resposta GeoDNS ruim afetam uma região por vez. Você detecta isso comparando a mesma verificação em diferentes continentes.
Uma página que carrega em 1,2s a partir de Chicago pode levar 5s em Sydney ou Joanesburgo — viagens TLS, distância e ativos não armazenados em cache se acumulam. Linhas de base por local indicam quais mercados precisam de presença de borda.
Algumas obrigações são geográficas: provar disponibilidade para clientes em um país específico, verificar que conteúdo com restrição geográfica se comporta corretamente ou evidenciar conformidade com SLA de onde o cliente realmente está.
A maneira mais rápida de fazer uma equipe de plantão ignorar seu monitoramento é alertá-la por uma falha em uma sonda. Uma única verificação falhada não é evidência de que um site está fora do ar — é evidência de que um caminho entre uma máquina e seu site falhou uma vez. Essas são reivindicações diferentes, e a rede te dá a segunda constantemente: uma flutuação transitória de rota, um evento momentâneo de perda de pacote, um nó de borda com limite de taxa, uma falha de resolvedor.
A verificação multi-local resolve a ambiguidade antes que um alerta saia da plataforma:
A verificação é registrada como erro naquele local, com a resposta completa, cabeçalhos e tempo capturados para o post-mortem. Nada é enviado ainda.
O mesmo dispositivo, mesmo script, mesmos limites — executados a partir de locais de monitoramento independentes em redes diferentes, em países diferentes.
Se os outros locais tiverem sucesso, a falha foi local em um caminho e o incidente não é aberto. Se eles também falharem, a interrupção é real e confirmada a partir de múltiplos continentes.
A notificação carrega a evidência consigo — quais locais falharam, quais tiveram sucesso e o que cada um viu — roteada através das suas regras de alerta e cronograma de escalonamento.
O resultado é um alerta que sua equipe pode agir sem precisar verificar manualmente primeiro. Também mostra o caso oposto: quando vários locais falham e alguns têm sucesso, você não está olhando para uma interrupção total — está olhando para uma regional, e a lista dos locais que falharam já é a primeira pista sobre onde.
Nossas 33 localizações públicas alcançam qualquer coisa que a internet pública possa alcançar. Aplicativos intranet, APIs internas, ambientes de staging e infraestrutura atrás de um firewall não estão, por design, nessa lista.
Para esses, instale um agente privado — o mesmo software de nó de monitoramento, rodando no seu próprio hardware dentro da sua própria rede. Ele aparece na sua conta como outro local de monitoramento, alimenta os mesmos painéis, relatórios e alertas, e se comunica somente em saída, então não são necessárias regras de firewall de entrada. Times frequentemente executam a mesma checagem de uma localização pública e de um agente privado ao mesmo tempo: quando a checagem pública falha e a interna passa, a falha está entre seu perímetro e a internet, não na aplicação.
Execute monitoramento de dentro do seu firewall contra aplicativos internos, APIs e infraestrutura que a internet pública não consegue alcançar.
Ping, traceroute e checagens de porta TCP direcionadas aos seus próprios hosts e rotas — de fora para dentro e de dentro para fora.
Direcione incidentes confirmados para a pessoa de plantão correta via e-mail, SMS, telefone, Slack, PagerDuty e webhooks.
De 33 locais de monitoramento em 18 países de 6 continentes: 10 na América do Norte, 7 na Europa, 12 na Ásia e Pacífico, e 4 na América do Sul, Oriente Médio e África. Cada local está nomeado nesta página, e os endereços IP atuais de cada um são publicados no artigo da base de conhecimento endereços IP dos locais de monitoramento.
Sim, por dispositivo de monitoramento. Você seleciona os locais ao criar ou editar um dispositivo, e pode alterar a seleção a qualquer momento. A maioria das equipes escolhe alguns que refletem onde seus usuários realmente estão, depois adiciona locais para investigar um mercado específico. Cada local selecionado executa a verificação no intervalo escolhido e reporta seus próprios resultados, para que você possa compará-los lado a lado.
Sim. Operamos 75 nós de monitoramento em IPv4 e 48 em IPv6. Vinte e seis dos 33 locais são dual-stack e respondem em ambos os protocolos; os sete que são apenas IPv4 são Buenos Aires, Varsóvia, Tel Aviv, Hong Kong, Qingdao, Tóquio e Singapura. Um nó, em São Francisco, é apenas IPv6, sem nenhum endereço IPv4. Esse nó somente IPv6 é quem detecta registros AAAA ausentes, regras de firewall apenas para IPv4 e balanceadores de carga sem listener v6 — falhas que a reversão para IPv4 mascara em todas as sondas dual-stack.
Todos eles. Todo local de monitoramento está disponível em todos os planos; não existe um nível geográfico que restrinja locais “globais”. O que varia entre os planos é o número de dispositivos de monitoramento e a frequência com que eles executam — veja a página de preços para os limites atuais, ou inicie um teste gratuito e configure os locais que você precisar.
Sim, utilizando agentes privados. Um agente privado é o mesmo software de nó de monitoramento instalado em seu próprio hardware dentro da sua rede, podendo assim acessar aplicações da intranet, APIs internas e infraestrutura com firewall. Ele aparece em sua conta como um local de monitoramento adicional e alimenta os mesmos relatórios e alertas que nossos locais públicos, comunicando apenas de forma outbound.
Quando um local reporta uma falha, a plataforma executa novamente a mesma verificação de outros locais antes de abrir um incidente. Se os outros obtiverem sucesso, a falha foi local em um caminho de rede e nenhum alerta é enviado. Se eles também falharem, a queda é confirmada por redes independentes em diferentes continentes e o alerta dispara com as evidências por local anexadas. Essa é a diferença entre uma página para a qual você pode agir e uma página que você aprende a ignorar.
Comece um teste gratuito de 30 dias, direcione um monitor para seu site e selecione todos os locais que você deseja. Não é necessário cartão de crédito.
Acesso completo à plataforma durante o período de teste — todos os locais de monitoramento, todos os tipos de verificação, sem necessidade de cartão de crédito.