世界中の組織
プラットフォーム稼働時間SLA
グローバル監視拠点
ウェブサイト監視リーダー
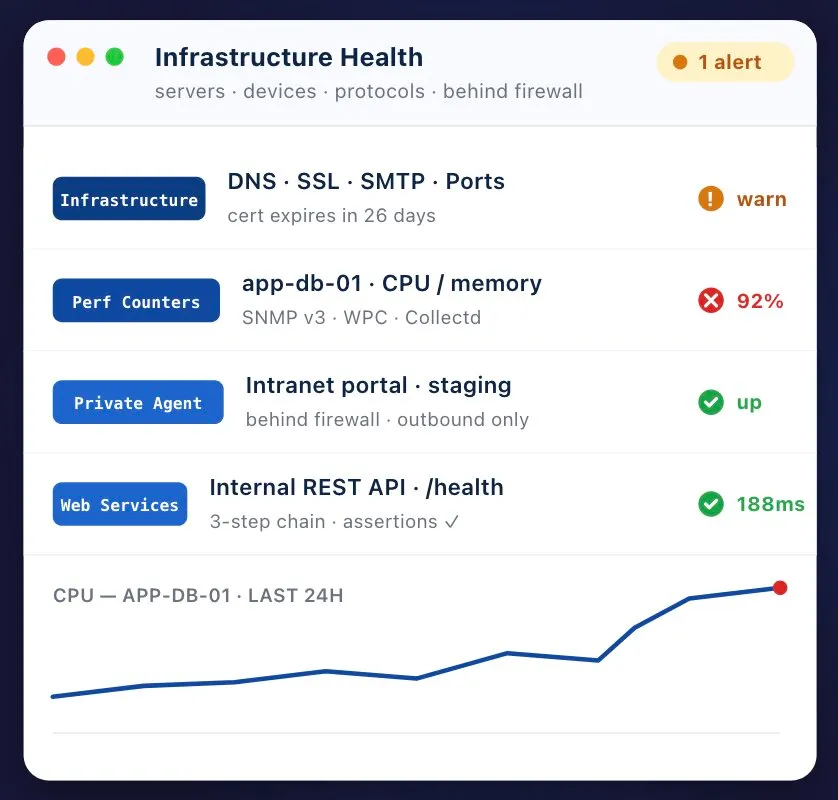
インフラストラクチャ監視 とは、アプリケーションの依存するサーバー、ネットワーク機器、プロトコル、内部システムを継続的にチェックし、それらが稼働中で到達可能かどうか、また許容範囲内で動作しているかを確認することです。Dotcom-Monitorは2方向からインフラを監視します:Internet Infrastructureは外部から可用性とプロトコルをチェックし、Performance Countersは内部からサーバーや機器の深いメトリクス(CPU、メモリ、ディスク、SNMPカウンター)を収集します。Private Agentsはあなたのファイアウォールの内側までこれら両方を拡張します。
ほとんどの監視ツールは一つの視点からしか監視しません。外部のチェッカーはサイトがダウンしていることは教えてくれますが、なぜなのかはわかりません。ボックス上のエージェントはCPUが限界に達していることは教えますが、DNS解決が半数のユーザーに対して失敗し始めたことは教えません。本当のインフラ問題はその境界を無視します—証明書の期限切れ、スイッチのパケット損失、ディスクの満杯、メールキューの溜まり—壊れたレイヤーは痛みを最初に感じるレイヤーとは限りません。
Dotcom-Monitorはそのギャップを一つのプラットフォームに統合します。Internet Infrastructureは6大陸の主要なインターネットバックボーン上の監視エージェントからプロトコルと稼働時間のチェックを実行します — 外側から内側への視点。Performance Countersはネットワーク内に軽量のコレクターをインストールし、Windowsパフォーマンスカウンター、Linux Collectdカウンター、およびサーバーやネットワーク機器のSNMPデータを収集します — 内側から外側への視点。Private Agentsはすべてのチェックタイプをプライベートネットワークに届けるので、内部アプリ、ステージング、ファイアウォールで保護されたデバイスも公開されているデバイスと同じ方法で監視されます。そして、Web Services、Web Applications、Web Pagesが同じダッシュボードを共有しているので、遅いチェックアウトの原因をスワッピングしているデータベースサーバーまで辿ることができます。
各プラットフォームはインフラストラクチャの異なるレイヤーをカバーしています。これらを一緒に実行すると、単一のダッシュボードで可用性、プロトコルの状態、デバイスのメトリクス、およびユーザー体験を上から表示します。赤いタイルから根本原因への一つのドリルダウンパスもあります。
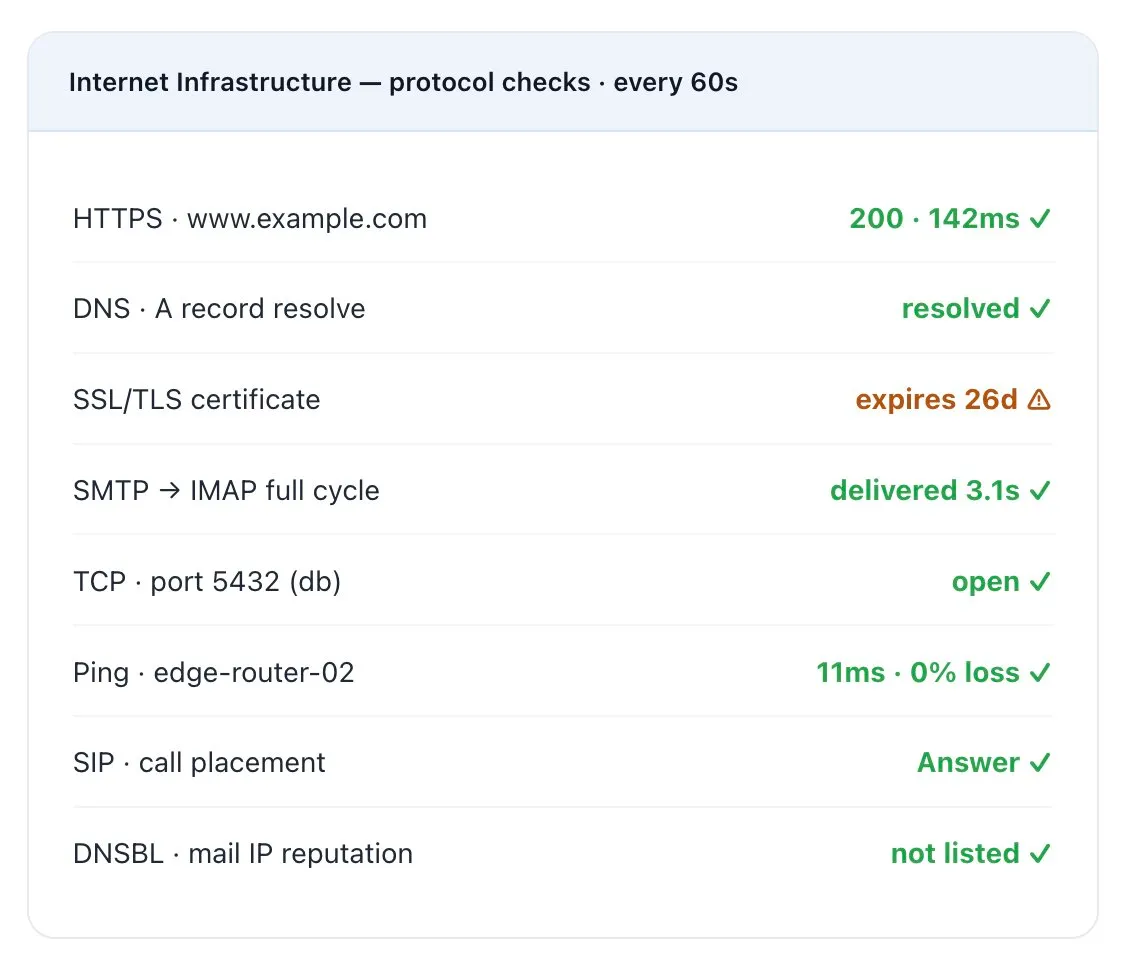
グローバルエージェントによる稼働時間とプロトコルチェック — HTTP/HTTPS、DNS、SSL/TLS証明書、SMTP/POP3/IMAPメール、FTP、VoIP/SIP、TCP/UDPポート、ICMP ping、トレースルート。
ネットワーク内部のエージェントによって収集された詳細なデバイスおよびOSメトリクス — Windowsパフォーマンスカウンター、Linux Collectd、SNMP v1/v2/v3、RESTを介したカスタムメトリクス。
パブリックIPのない内部システムに対して任意のチェックタイプを実行します。アウトバウンドのみのクラウド接続 — インバウンドファイアウォールルール不要、パブリックモニターと同じダッシュボード。
マルチステップAPIおよびウェブサービスチェック — REST、SOAP、GraphQL、WebSocket — ステータス、レイテンシー、ペイロードに関するアサーション付き。内部のヘルスエンドポイントやサービスメッシュを監視。
フルスタックをエンドツーエンドで実行するスクリプト化されたブラウザ取引により、インフラの障害が壊れたステップとしてスクリーンショット、ビデオ、ウォーターフォールと共に表示されます。
リアルブラウザのページロードとCore Web Vitalsチェックにより、バックエンド、CDN、またはサードパーティの依存関係がフロントエンドを遅延させているタイミングがわかります。
インターネットインフラは、外部世界が実際に到達する方法でサーバー、ネットワーク、サービスをチェックします。主要なインターネットバックボーンに配置された世界中の監視エージェントからの監視です。複数エージェントによる冗長チェックにより、ページ呼び出し前にすべての障害を検証するため、誤警報ではなく本物のアラートを受け取れます。
用途:ウェブ&アプリサーバー ・ DNS ・ メール ・ VoIP ・ ネットワーク機器 ・ 証明書
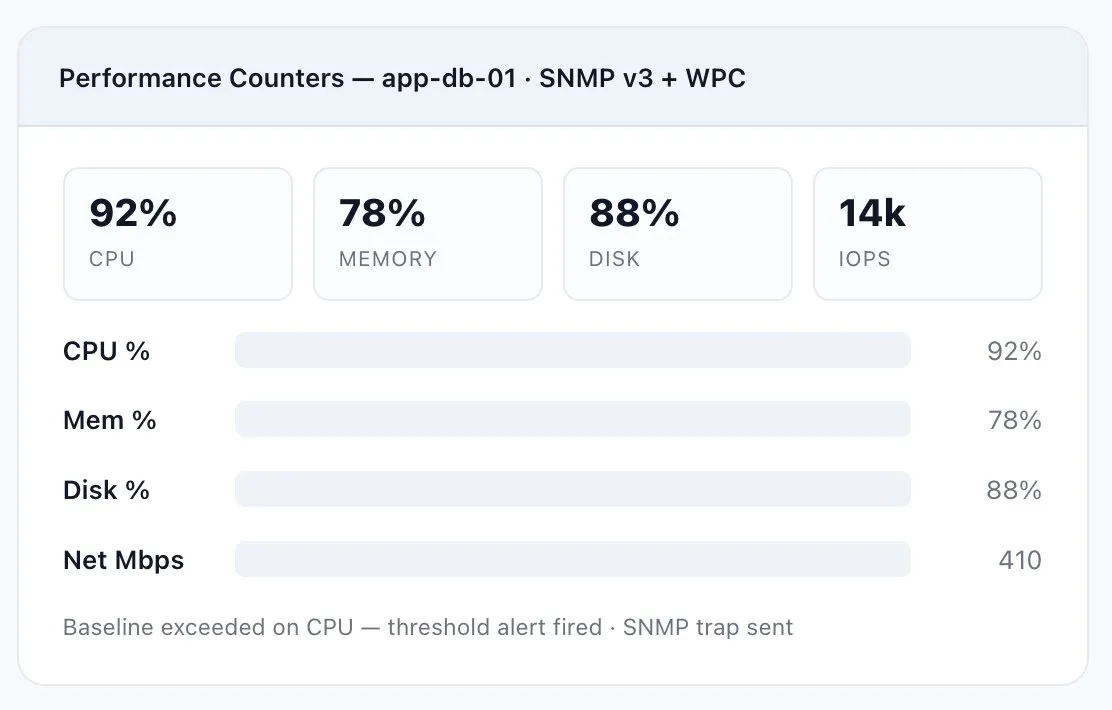
パフォーマンスカウンターは外部チェックが見えないメトリックを取得します。ネットワーク内の単一マシンにパフォーマンスカウンターエージェントをインストールし、サーバーやネットワーク機器から性能データをポーリングします。すべてのボックスにエージェントは不要で、1つのコレクターが権限のある任意のリモートノードからデータを収集可能です。
用途例:CPU · メモリ · ディスク · スイッチ&ルーター · SNMP デバイス · カスタムテレメトリ
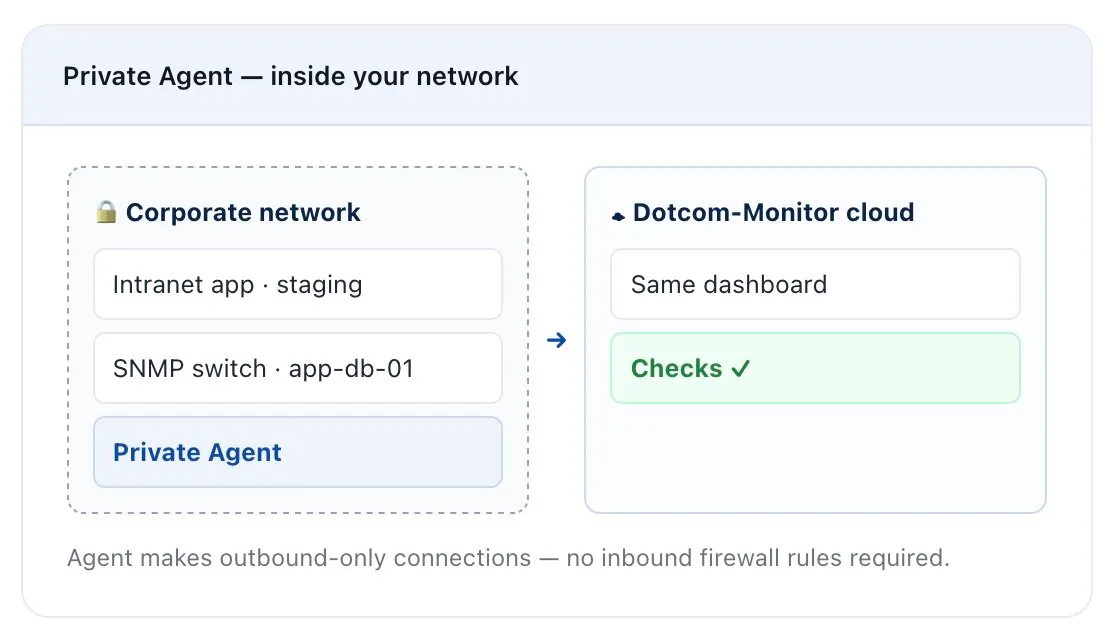
イントラネットアプリ、ステージング環境、内部API、パブリックIPのないデバイスは監視が必要です。信頼されたネットワーク内のWindowsやLinuxホスト上のプライベートエージェントをデプロイしてください。VM、ジャンプボックス、専用アプライアンスなどからDotcom-Monitorへ単一のアウトバウンドHTTPSセッションを開きます。インバウンドのファイアウォールルールは不要、穴は開けません。
用途例:内部アプリ · ステージング · VPN専用システム · ファイアウォール内デバイス · 本番前環境
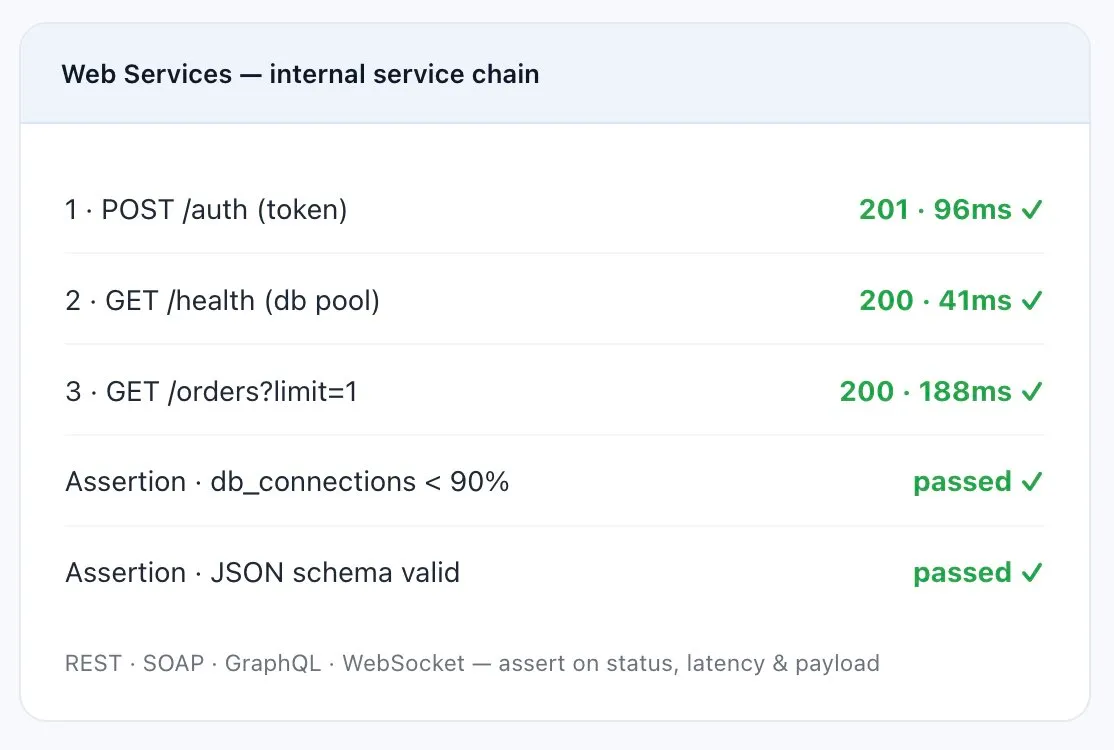
インフラはハードウェアだけではなく、それを結ぶ内部APIやサービスも含まれます。WebサービスはREST、SOAP、GraphQL、WebSocketエンドポイントに対してマルチステップチェックを実行し、ステータスコード、応答時間、ペイロード内容を検証することで、上層アプリが障害に気づくより前にサービスの劣化を把握できます。
用途例:ヘルスエンドポイント · 内部API · マイクロサービス · メッセージキュー · サービスメッシュ
ウェブアプリケーションとウェブページはスタックの最上位にあり、エンド・ツー・エンドでそれを動かします。インフラの下層で何かが壊れると、失敗したステップや遅いページとして表れ、その発生場所を証明するエビデンスが添付されます。
EveryStepレコーダーを使って、実際のユーザージャーニー(ログイン、検索、カートに追加、チェックアウト)を記録し、実際のブラウザーでスケジュール実行します。バックエンドのタイムアウト、期限切れの証明書、依存関係の不具合はスクリプトを正確なステップで停止させ、その瞬間のスクリーンショット、セッションビデオ、コンソールログ、ウォーターフォールを取得します。
デスクトップとモバイルの実際のブラウザから、Largest Contentful Paint、Time to Interactive、およびロードウォーターフォールを測定します。要素レベルのタイミングにより、遅いバックエンドの応答、過負荷のサーバー、またはサードパーティの依存関係がページを遅くしている原因であり、フロントエンドのコードではないことが明確になります。
インターネットインフラストラクチャのチェックは、6大陸にわたるtier-3データセンターエージェントから実行されるため、地域的なDNS障害やISPのルーティング変更をサポートチケットが来る前に検知可能です。パフォーマンスカウンターとプライベートエージェントはネットワーク内部で動作し、ファイアウォール内のサーバーやSNMPデバイスも同じ厳格さでカバーします。両者は1つのダッシュボード、1つのアラートエンジン、1つのSLAレポートセットを共有します。
監視エージェントの大陸数
チェック頻度は最短1分間隔
対応SNMPバージョン
インフラ監視開始年
インターネットインフラストラクチャをパブリックURL、ホスト、プロトコルに向けます。関連チェックをデバイスにグループ化して、レポートとアラートを見やすく整理しましょう。
SNMPおよびパフォーマンスカウンターを収集するためにPerformance Countersエージェントをインストールし、ファイアウォールの背後にある任意のものにアクセスするためにPrivate Agentをインストールします。
ベースラインパフォーマンスを確立し、メトリックごとに許容しきい値を定義し、チェック頻度を最大1分まで選択します。
検証済みのアラートを適切なチームに送信し、冗長チェックで誤報を抑制し、SLAおよびトレンドレポートをエクスポートします。
6大陸にわたるTier-3チェックポイント。特定の地域からチェックを実行して、障害が自分のものかネットワークのものかを推測するのではなく、ジオルーティング、CDN、ISPレベルの問題を特定します。
インターネットインフラプロトコルチェック、Performance Countersデバイスメトリック、Web Services API、およびフロントエンドチェックを1つのビューに統合。集計ヘルスタイルから単一の失敗チェックへ秒単位で掘り下げ可能。
Performance Countersは各カウンターのベースラインパフォーマンスを確立し、レポートでトレンドをキャプチャし、許容範囲外に値が逸脱した場合には変数またはデータポイントごとにアラートを発動します。
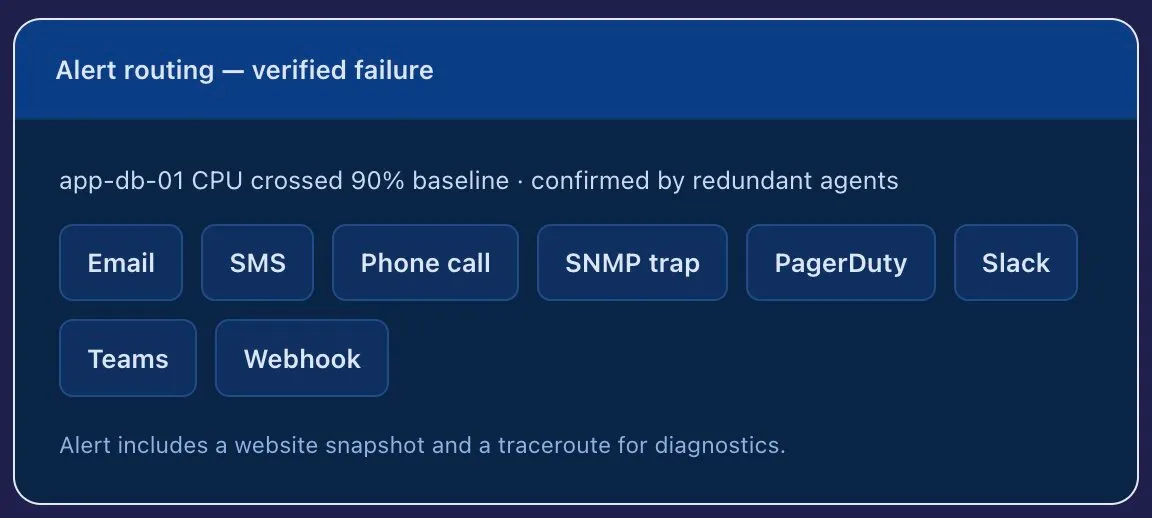
複数エージェントによる冗長チェックが故障を確認してからページングされます。PagerDuty、Slack、Teams、メール、SMS、音声、SNMPトラップ、またはWebhookへ経路指定可能で、スナップショットとトレースルートが添付されます。
プライベートエージェントはアウトバウンドのみで接続するため、内部の何もインターネットに公開されません。ファイアウォールやVPN限定のシステムを1つもインバウンドポートを開けずに監視します。
リアルタイムダッシュボード、スケジュールされたPDF/CSVエクスポート、稼働時間、応答時間、エラー率に対する閾値のSLAレポート—MSPや代理店向けのホワイトラベルオプション付き。
チームがどのようにインターネットインフラ、パフォーマンスカウンター、プライベートエージェントを組み合わせて重要なインフラを健全に保っているか。
パフォーマンスカウンターはサーバーやネットワーク機器のラック全体のCPU、メモリ、ディスク、SNMPカウンターを追跡し、インターネットインフラは上位のサービスがアクセス可能であることを確認します。ベースラインはテナントに被害が及ぶ前にホットノードを検知します。
プライベートエージェントはファイアウォールの内側のイントラネットポータル、SSO、ステージング環境を監視し、インターネットインフラはDNS、証明書、メールを監視します。パブリックとプライベートの双方を1つのダッシュボードで。
顧客: Dell、Citrix、Xerox。
SIPコールプレースメントチェックは音声サービスが実際に接続されているか確認し、pingとtracerouteでネットワーク経路をマップし、パフォーマンスカウンターはキャリア規模のスイッチやルーターからSNMPメトリクスを取得します。
顧客: Comcast、Dish。
メールサーバーのフルサイクルチェック、証明書有効期限アラート、コンプライアンス監査を満たすSLAレポート。冗長な検証で誤報を規制されたオンコールローテーションの外に保ちます。
顧客: Aflac。
ポートとデータベース接続チェック、Webサービス経由のAPIヘルス、およびWebアプリケーションのチェックアウトスクリプトを重ねることで、インフラストラクチャ障害はコンバージョンレポートに影響が出る前の段階で問題のあるステップとして検出されます。
監視は外側から内側へ、内側から外側へと行われるため、ランタイムは重要ではありません。ベアメタル、VM、Kubernetes、サーバーレスのいずれであっても、パブリックエンドポイントは外部から、ホストは内部から同じ方法でチェックします。
ほとんどのインフラツールはエージェント優先でホスト単価のため、すべてをカバーするには急速に費用がかさみます。Dotcom-Monitorはエージェント不要の外部チェックと軽量の内部コレクターを組み合わせており、ボックス単価ではなくモニター単価で価格設定されています。
機能 | Dotcom-Monitor | Datadog | SolarWinds | PRTG | Site24x7 |
|---|---|---|---|---|---|
グローバルエージェントによる外側から内側へのプロトコル&稼働時間チェック | はい | アドオン | アドオン | 制限あり | はい |
SNMP v1/v2/v3 & パフォーマンスカウンター収集 | はい | はい | はい | はい | はい |
1つのエージェントで多数のリモートノードを収集 | はい | ホストごと | 部分的 | はい | 部分的 |
プライベートエージェントがファイアウォールの背後でフルチェックセットを実行 | はい | 部分的 | 部分的 | はい | はい |
フルサイクルメール(SMTP → IMAP/POP3)チェック | はい | いいえ | 部分的 | 部分的 | 部分的 |
VoIP/SIP通話配置監視 | はい | いいえ | 部分的 | 部分的 | いいえ |
同一プラットフォーム上のフロントエンド(Webアプリケーション / Webページ) | はい | はい | 部分的 | いいえ | はい |
モニターごとの固定料金 — ホストごとや取り込み料は不要 | はい | ホストごと | ノードごと | センサー基準 | プラン基準 |
ホワイトラベル / MSPリセラー用レポート機能 | はい | いいえ | 部分的 | 部分的 | はい |
1990年代からの専用モニタリングベンダー | 1998年 | 2010年 | 1999年 | 2003年 | 2006年 |
「アドオン / 部分的 / 制限付き」=制限付きで利用可能、別モジュールとして、または上位プランで利用可能。競合他社の機能や価格モデルは頻繁に変わるため、2026年7月時点の情報をまとめています。最新の詳細は各ベンダーにてご確認ください。
Internet InfrastructureでDNS、SSL/TLS証明書、SMTP/POP3/IMAP、FTP、VoIP/SIP、およびTCP/UDPポートを監視します。複数の地域からpingとtracerouteを実行してISPのルーティング変更やパケットロスを検出し、Performance Countersを使ってSNMP経由でスイッチやルーターをポーリングします。
Performance CountersでWindowsのパフォーマンスカウンターとLinuxのCollectdメトリクスを収集し、CPU、メモリ、ディスクのベースラインとしきい値を設定し、ノードが逸脱した瞬間にアラートを受け取ることができます。1つのコレクターで複数のマシンをカバーします。
ダッシュボード上で失敗したWebアプリケーションのステップや遅いWebサービスAPIを基盤となるホストメトリクスと相関付けます。シンセティックチェックに基づくデプロイ制御や、スプレッドシートではなくSLAレポートでエラーバジェットを追跡します。
プライベートエージェントはアウトバウンド専用で接続するため、ファイアウォールやVPN限定のシステムもインバウンドポートの開放なしでカバーされます。証明書の有効期限切れやDNSBLチェックで一般的なセキュリティギャップを埋め、SLAレポートは監査要件を満たします。
アラート、ダッシュボード、データはチームが既に使っているツールに流れ込みます。
異なるデバイスを異なるエスカレーションチェーンにルーティングし、メンテナンスウィンドウ中はアラートを抑制し、チームが依存する全てのチャネルで配信します。
検証済みの障害を自動的にチケットに変換し、パイプラインから直接デプロイ後のインフラチェックをトリガーします。
Dotcom-Monitor REST APIはモニターのプロビジョニング、履歴データの取得、設定の管理を行い、Performance Countersは独自のセンサーからREST経由でカスタムメトリクスを受け入れます。
インフラモニタリングとは、アプリケーションが依存するサーバー、ネットワーク機器、プロトコル、内部システムを継続的に監視し、それらが稼働中で到達可能かつ設定した閾値内で性能を発揮していることを確認することです。Dotcom-Monitorは二つの視点から監視しています:インターネットインフラはネットワーク外部からの可用性やプロトコルをチェックし、Performance Countersは内部から深いOSおよび機器のメトリクス(CPU、メモリ、ディスク、SNMPカウンター)を収集します。
Internet Infrastructureは外部から内部へ監視します:グローバルな監視エージェントが稼働時間、応答時間、HTTP、DNS、SMTP/POP3/IMAP、FTP、SIP/VoIP、TCP/UDPポート、ICMP ping、tracerouteなどのプロトコルをチェックし、外部世界がインフラにどのようにアクセスするかを確認します。Performance Countersは内部から外部へ監視します:ローカルにインストールされたエージェントがWindows Performance Counters、Linux Collectdカウンター、SNMP v1/v2/v3データをサーバーやネットワーク機器から収集し、同じダッシュボードにフィードしてベースライン設定、閾値監視、アラートを行います。ほとんどのチームは両方を運用します。
ネットワーク内部のマシンにPerformance Countersエージェントをインストールします。Windows Performance Counters、Linux Collectdカウンター、SNMP対応デバイスをポーリングします—v1/v2はコミュニティストリングとOIDを使用し、v3はユーザー名とパスワード、暗号化を用います。エージェント1台が権限のあるリモートノードからデータを収集できるため、全マシンにエージェントが必要とは限りません(そのノードに管理者権限または「Performance Monitor Users」権限が必要です)。Dotcom-Monitorはスケジュールに沿ってエージェントをポーリングし、ベースライン、閾値アラート、トレンドレポート用にデータを集約します。
はい。ネットワーク内部のWindowsまたはLinuxホストにプライベートエージェントを展開します。これはアウトバウンドのみの接続をDotcom-Monitorに行い、インバウンドのファイアウォール設定は不要です。HTTP/HTTPS、REST、SOAP、GraphQL、WebSocket、Webページ、Webアプリケーション、Internet Infrastructure、Performance Countersのすべてのタスクを内部システムに対して実行します。結果はパブリックモニターと同じダッシュボードで表示されます。
Internet Infrastructureはウェブおよびアプリケーションサーバー(HTTP/HTTPS、500などのエラー応答を含む)、メールサーバー(SMTP、POP3、IMAP、送受信の完全なサイクルを含む)、DNSサーバー、FTPサーバー、VoIP/SIPシステム、ストリーミングメディアサーバー、TCPおよびUDPポート、ICMP pingおよびtracerouteを使ったIPレベルの直接接続をチェックします。また、SSL/TLS証明書の有効性とDNSブラックリスト(DNSBL)ステータスも確認します。
障害が発生する層でそれを検出することによってです。性能カウンターのディスク劣化やCPUカウンターの上昇はアプリが遅くなる前に警告を出します。Internet Infrastructureの失敗したプロトコルチェックはDNS、SSL、ポート、またはアプリ層のどれが壊れたかを特定し、アラート内のtracerouteはパケットが失われている経路上の場所を示します。この層ごとの証拠により、どのコンポーネントが故障したのかを推測する時間が減り、解決が速まります。
いいえ。Internet InfrastructureのチェックはDotcom-Monitorの外部エージェントから完全に実行されるため、あなた側には何もインストールしません。Performance Countersはネットワークセグメントごとに1台のマシンにエージェントが必要ですが、権限を持つ他のノードからも収集します。同様に、単一のPrivate Agentは多数の内部ターゲットをカバーします。ネットワーク内部にアクセスする必要のある場所にだけエージェントをインストールし、すべてのボックスにインストールする必要はありません。
メール、SMS、電話、SNMPトラップ、PagerDuty、Slack、Microsoft Teams、Opsgenie、Webhookによるアラートです。条件は冗長化されたエージェントでの検証済み障害を必要とし、誤報を抑制できます。アラートには診断用にウェブサイトのスナップショットやtracerouteを含めることも可能です。レポートにはベースライン、トレンドレポート、閾値レポート、SLAレポートがあり、MSP向けのホワイトラベルオプションもあります。
すべてのプラットフォームでPrivate AgentsおよびPerformance Countersを含む完全な機能アクセスが可能な30日間の無料トライアルがあります。開始にクレジットカードは不要です。
料金はモニター数、チェック頻度、プラットフォームの組み合わせに基づきます。ホスト単位や席単位ではなく、データ取り込み量による課金もありません。最新プランについては料金ページを参照するか、カスタム見積もりは営業にお問い合わせください。
最初のチェックは数分で設定可能で、必要に応じてPerformance CountersやPrivate Agentsを追加できます。クレジットカードも営業からの電話も不要ですぐに始められます。