Tu consola en la nube está en verde. Tus alertas están silenciosas. Y la cola de soporte se está llenando con clientes que no pueden iniciar sesión.
Esa combinación es más común de lo que la mayoría de los equipos admite, y generalmente no es una mala configuración. El monitoreo nativo de la nube se ejecuta dentro de la misma infraestructura sobre la que informa; por lo tanto, cuando esa infraestructura tiene un mal día, su propia telemetría es el último lugar para buscar una respuesta independiente.
Si estás comparando herramientas de monitoreo de infraestructura en la nube ahora mismo, esa brecha debería guiar tu lista corta más que cualquier matriz de características. A continuación: lo que el monitoreo de tu proveedor puede y no puede ver, cómo probar a un proveedor contra los fallos que realmente tienes y qué términos de precios sorprenden a los equipos aproximadamente a los seis meses.
Qué incluye esta guía
- Por qué el monitoreo de tu proveedor de nube no puede ver la falla
- Lo que realmente mide el monitoreo nativo en la nube
- Tres fallos que aparecen en verde en un panel de la nube
- Cómo evaluar una herramienta de monitoreo de infraestructura en la nube
- Qué métricas pertenecen a tu prueba de lista corta
- Dónde los precios de monitoreo en la nube sorprenden a los equipos
- Preguntas para hacer en cada llamada con proveedores
- La conclusión sobre el monitoreo de infraestructura en la nube
- Preguntas frecuentes
Por qué el monitoreo de tu proveedor de nube no puede ver la falla
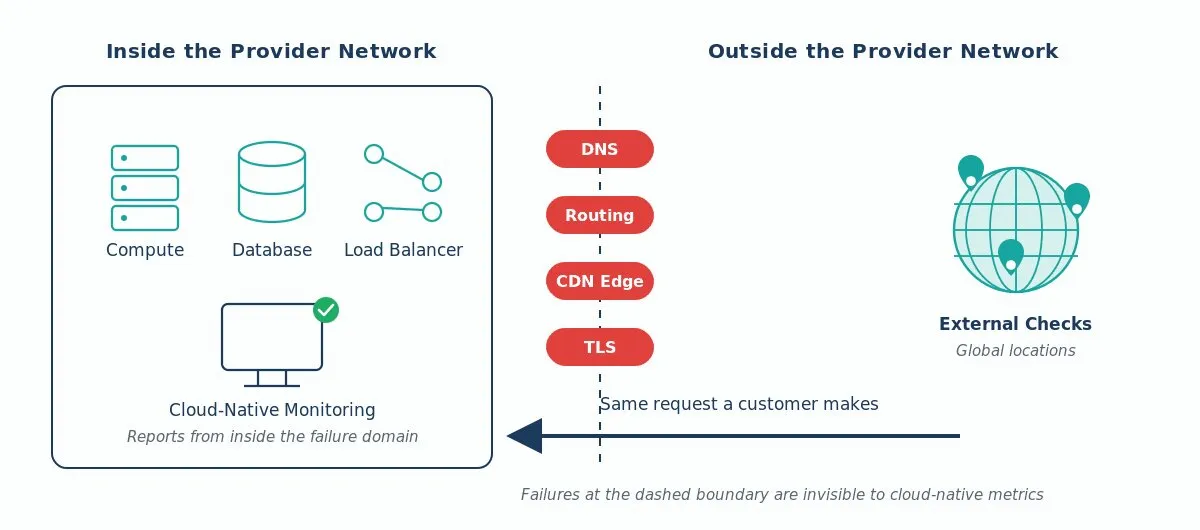
Cada sistema de monitoreo tiene un punto de vista. El punto de vista de tu proveedor está dentro de su propia red.
Una definición primero, porque decide el resto del argumento. El monitoreo nativo en la nube aquí significa las métricas y alarmas de recursos predeterminadas que obtienes con la plataforma —Amazon CloudWatch, Azure Monitor, Google Cloud Monitoring— no cada función de disponibilidad que el proveedor vende junto a ellas.
Esos valores predeterminados son útiles. CloudWatch te dirá si una instancia está al 100 % de CPU, que un grupo de Auto Scaling agregó capacidad, que las conexiones de base de datos están agotadas. Señales reales, y debes seguir recopilándolas.
Pero la verificación se ejecuta en el plano de control del proveedor, a través de su red, contra su API. Si el plano de control se degrada, el canal de métricas se degrada junto con él. Y las métricas retrasadas parecen exactamente como métricas saludables en un tablero: no se dispara ninguna alarma, porque no llegó ningún dato que la active.
El segundo límite importa más para cualquier cosa orientada al cliente. Esas métricas predeterminadas miden tus recursos, no el camino entre un usuario en São Paulo y tu balanceador de carga en us-east-1. Resolución DNS, enrutamiento BGP, comportamiento del CDN en el borde, negociación TLS, scripts de terceros, reglas WAF — todo está fuera de ese límite, y cualquiera de ellos puede derribar tu servicio mientras la CPU y la memoria se mantienen constantes.
Un sistema de monitoreo que vive dentro del dominio de fallo es el último en decirte que ese dominio está roto.
¿Pero CloudWatch Synthetics no hace esto ya?
En parte, y esta objeción vale la pena tomarla en serio. Cada proveedor importante vende algo aquí: canarios de CloudWatch Synthetics, verificaciones de salud de Route 53, pruebas de disponibilidad de Azure Monitor, chequeos de uptime de Google Cloud. Ejecutan solicitudes reales contra tus puntos finales y funcionan.
La trampa es desde dónde se ejecutan. Esas verificaciones se ejecutan en la infraestructura del mismo proveedor y publican resultados en la misma consola, la cobertura fuera de sus regiones es limitada, y un evento regional amplio puede afectar las verificaciones y la carga de trabajo juntas. Herramientas útiles, pero no independientes.
La independencia es el verdadero requisito, y es justo devolvérselo a cualquier vendedor. Muchos servicios de monitoreo de terceros también operan en una nube mayor. Por lo tanto, pregunta dónde se encuentran las ubicaciones de verificación: una red que abarca múltiples proveedores y nodos operados por operadores, o tres regiones alquiladas de la nube que ya usas. Dotcom-Monitor ejecuta su propia red mundial de monitoreo en lugar de alquilar regiones, y eso es lo que hace que la verificación sea significativa.
Puedes construir una versión de esto. Prometheus Blackbox Exporter examina puntos finales, y para uno o dos puntos de vista esa es una respuesta razonable. El coste aparece cuando necesitas docenas de geografías, renderizado con navegador real y alguien de guardia para las sondas mismas.
De cualquier manera, ejecuta la verificación desde fuera del sistema que estás verificando. El monitoreo sintético envía solicitudes a través de internet pública en un horario que defines. Si una falla, la escuchas por la verificación y no por un cliente.
Lo que realmente mide el monitoreo nativo en la nube
Aquí está la división, capa por capa. Mapea tu cobertura actual contra esto antes de hablar con cualquier proveedor.
| Capa | Métricas predeterminadas de la nube | Verificaciones externas independientes |
|---|---|---|
| CPU, memoria, disco en tus instancias | Sí, y en detalle | No |
| Salud de base de datos gestionada y colas | Sí | Indirectamente, vía comportamiento de la aplicación |
| Eventos de escalado automático y despliegue | Sí | No |
| Resolución pública de DNS | Parcial, desde dentro de la VPC | Sí, desde resolvedores reales de todo el mundo |
| Validez del certificado TLS en el borde | Parcial | Sí |
| Ruta y enrutamiento de red hacia los usuarios | No | Sí |
| Comportamiento de CDN y caché en el borde | No | Sí |
| Viaje completo de inicio de sesión o checkout | No | Sí |
| Fallas de API y scripts de terceros | No | Sí |
Ninguna columna reemplaza a la otra. Las herramientas de tu proveedor son el mejor instrumento para diagnosticar la causa raíz una vez que sabes que algo está mal. Las verificaciones externas son lo que te dice que algo está mal en primer lugar — y siguen reportando cuando el canal del proveedor se detiene. Nuestro post sobre qué cubre el monitoreo de infraestructura profundiza más en el lado de nivel de recurso.
Ejecuta ambos. Presupuesta para ambos.
Tres fallos que aparecen en verde en un panel de la nube
Estos son patrones, no estudios de caso. Ejecuta cargas de producción en AWS, Azure o Google Cloud durante un par de años y al menos uno te será familiar.
Un registro DNS que falló para la mitad de tus usuarios
Alguien actualiza un registro durante una migración. El cambio es correcto en el servidor de nombres autorizado, por lo que todas las verificaciones internas pasan. Pero el punto final antiguo fue desmantelado antes de que expirara el TTL anterior, por lo que los resolvedores recursivos alrededor del mundo siguen entregando la dirección antigua hasta que su copia en caché expira. Una porción de tu tráfico sigue llegando a algo que ya no responde.
Tus instancias están saludables. Tu balanceador de carga ve menos tráfico y no reporta nada inusual. Detectar esto significa resolver el nombre desde fuera, desde múltiples geografías, la forma en que lo haría un cliente real. Eso es lo que hace el monitoreo DNS, y por eso la ubicación del resolvedor importa en una evaluación.
Un certificado que expiró en un balanceador de carga
La renovación ahora es automática, que es exactamente por lo que falla silenciosamente. Un trabajo falla, nadie se da cuenta y el certificado en un listener o en una propiedad de borde de CDN se agota.
Las instancias detrás están bien. La CPU está bien. Los registros de la aplicación muestran una caída en las solicitudes, no un error. Mientras tanto, los navegadores muestran una advertencia intersticial a cada visitante. El monitoreo de certificados SSL que valida la cadena desde fuera detecta esto semanas antes.
Una región marcada como funcionando normalmente
Las páginas de estado del proveedor generalmente esperan la confirmación interna antes de que algo cambie de color. Eso es una forma razonable de evitar falsas alarmas entre millones de clientes, y también significa que la página tiende a estar retrasada respecto al incidente. Los equipos ven rutinariamente errores antes de que el tablero se ponga amarillo.
Si tu respuesta al incidente depende de la página de estado, has entregado tiempo de detección al proceso de revisión de otro. Las verificaciones independientes te dan tu propia línea de tiempo — durante el incidente y después, cuando haces la conciliación contra un SLA. Esos son los datos que hacen que los informes de uptime y SLA valgan algo en una disputa de crédito.
Cómo evaluar una herramienta de monitoreo de infraestructura en la nube
La mayoría de las comparaciones de proveedores clasifican características. Eso te dice muy poco — las listas de características se han convergido, y la mitad describen la misma capacidad bajo diferente marca. En su lugar, prueba contra tus propios fallos.
Paso 1: Anota los últimos cinco incidentes que realmente tuviste. Sácalos de tu sistema de tickets, no de memoria, y anota cómo supiste de cada uno. Si más de uno vino de un cliente, tienes un problema de detección, no un problema de tablero.
Paso 2: Verifica desde dónde el proveedor ejecuta sus verificaciones. Pide la lista de ubicaciones, no un conteo, y pregunta quiénes son los dueños de esas ubicaciones. Treinta ubicaciones agrupadas en Norteamérica y Europa Occidental no dicen nada sobre usuarios en el Sudeste Asiático. Ubicaciones alquiladas en la nube que ya usas no dicen nada durante un evento regional.
Paso 3: Prueba un recorrido en múltiples pasos, no un ping a la página de inicio. Un 200 en tu URL raíz no prueba casi nada. Scriptea un inicio de sesión, una búsqueda, añadir al carrito, una llamada API autenticada con una credencial de prueba con alcance limitado. Las verificaciones de código de estado pasan todas las pruebas que les das y aún así pierden la falla que te cuesta dinero. EveryStep maneja el caso de viaje grabado.
Paso 4: Rompe algo a propósito durante la prueba. Apunta una verificación a un hostname de staging que controlas, luego elimina el registro DNS o devuelve un 500 duro. Cronometra la alerta y lee lo que dice. Esta es la hora más útil que pasarás en cualquier prueba.
Paso 5: Lee la alerta como si te hubiera despertado. ¿Nombra el paso fallido, la ubicación, la clase de error, el tiempo de respuesta? ¿O dice simplemente “sitio caído”? Esa diferencia decide si tu ingeniero de guardia comienza a arreglar a las 2:04 am o solo empieza a investigar. Revisa cómo la alerta se integra con lo que ya usas—PagerDuty, Slack, Teams, un webhook.
Paso 6: Confirma que también llega a tus sistemas internos. Mucho de lo que manejas no es público: paneles administrativos, API internas, staging, cualquier cosa detrás de un VPN. Una herramienta que solo ve internet abierta te deja comprando una segunda. Los agentes privados ejecutan verificaciones desde dentro de tu red y reportan a la misma consola.
Paso 7: Modela la factura al tamaño de próximo año. Duplica el conteo actual de verificaciones, aplica el intervalo que realmente quieres usar en lugar del que encaja con la demo, y pide ese número por escrito.
Qué métricas pertenecen a tu prueba de lista corta
El porcentaje de disponibilidad termina en la presentación para la junta, y es el número menos útil durante una evaluación — las cifras de uptime redondean justo los fallos que te importan. Pide estas en cambio:
- Tiempo para detectar. Minutos entre el inicio del fallo y la llegada de la alerta. Este es el número que justifica la compra.
- Tiempo de respuesta por ubicación. Un p95 por región, no un promedio global que oculta tus mercados lentos.
- Desglose de errores por capa. DNS, TCP, TLS, HTTP, aserción de contenido. Una herramienta que reporta “fallo” sin nombrar la capa te devuelve la depuración.
- Comportamiento de confirmación de fallos. Cuántas ubicaciones deben estar de acuerdo antes de disparar una alerta, y cuán rápido. Muy laxo genera ruido; muy estricto genera demora.
- Retención de datos brutos de verificación. Los resúmenes son válidos para reportes. La revisión post-incidente necesita las verificaciones individuales.
Los backends distribuidos complican esto—las dependencias fallan parcialmente y los síntomas se traslapan. Nuestra guía sobre monitoreo de sistemas distribuidos cubre ese caso.
Dónde los precios de monitoreo en la nube sorprenden a los equipos
Las facturas de monitoreo tienden a crecer más rápido que la infraestructura que vigilan. Dónde pasa eso:
Precio por host en un entorno de autoescalado. Si te facturan por host monitoreado y tu flota escala con el tráfico, también la factura. Pregunta cómo cuentan las instancias efímeras y en qué ventana.
Métricas personalizadas y etiquetas de alta cardinalidad. El monitoreo nativo en la nube a menudo cobra por métrica personalizada por mes. Añade una etiqueta de alta cardinalidad — un ID de cliente, un ID de contenedor — y el conteo se multiplica sin que nadie decida gastar más.
Ingesta, retención, usuarios y SMS. El volumen de logs rara vez baja, así que revisa qué pasa en cada escalón del plan y si la retención se cobra aparte de la ingesta. Algunas plataformas también facturan por usuario, lo que convierte “dar acceso de lectura al soporte” en una conversación de presupuesto, y cobran por SMS y alertas de voz por separado.
Frecuencia de verificación. Con proveedores que facturan por ejecución, pasar de un intervalo de cinco minutos a uno de un minuto multiplica por cinco el coste de ese monitor. Otros agrupan ejecuciones o limitan la frecuencia según el nivel del plan, así que la forma varía — pero raramente es gratis, y decide si detectas una falla corta o la pierdes. Cotiza la frecuencia que vas a usar realmente, por servicio. La tarifa de Dotcom-Monitor es por verificación y por intervalo, así que esa matemática es fácil de hacer por adelantado.
Compara el total con el coste del tiempo de inactividad de tu propio servicio. Para la mayoría de equipos la línea de monitoreo es pequeña comparada con una mala hora — pero ten esa comparación escrita antes de la conversación de renovación.
Preguntas para hacer en cada llamada con proveedores
Lleva estas preguntas a la demo. Las respuestas separan las herramientas rápidamente:
- ¿Quién es el propietario de tus ubicaciones de verificación — tus propios nodos, instalaciones de operadoras o regiones alquiladas en AWS, Azure o Google Cloud?
- ¿La verificación usa un navegador real o un cliente HTTP, y qué cambia eso sobre lo que detecta?
- ¿Cómo monitoreas un punto final que requiere OAuth o SSO?
- ¿Cuántas ubicaciones deben fallar para que emitáis alerta, y eso se puede ajustar?
- ¿Cuánto tiempo guardan los resultados brutos de las verificaciones, y puedo exportarlos?
- ¿Cómo queda la factura si doblo mis verificaciones y reduzco a la mitad el intervalo?
Para el proceso de selección más amplio — estabilidad del proveedor, soporte, términos contractuales — lo hemos escrito aparte en nuestras directrices para elegir una plataforma de monitoreo.
La conclusión sobre el monitoreo de infraestructura en la nube
Mantén el monitoreo de tu proveedor. Es el mejor instrumento que tienes para diagnóstico a nivel de recursos, ya está desplegado y las métricas básicas vienen con la computación. Observa la factura por métricas personalizadas, logs y retención, pero mantenlo.
Solo no lo conviertas en tu detector de fallas. Reporta desde dentro del sistema que vigila, y las métricas predeterminadas no pueden ver el camino de red, la resolución pública de DNS, el certificado en el borde o el flujo de inicio de sesión del que dependen tus clientes. Esos son los fallos que llegan primero a tu cola de soporte.
La evaluación que funciona es corta: lista tus incidentes reales, prueba a los candidatos contra esos fallos, rompe algo en la prueba, calcula el precio de la configuración que vas a usar realmente. Una herramienta que hubiera detectado tus últimos cinco fallos cinco minutos antes se ha pagado sola.
Ve lo que detectan las verificaciones externas
Dotcom-Monitor ejecuta verificaciones con navegador real y protocolos contra tu infraestructura en la nube desde una red global de ubicaciones, además de agentes privados para cualquier cosa detrás de tu firewall. Inicia una prueba gratuita y apunta una verificación al servicio del que menos confianza tengas.
Explora el monitoreo de infraestructura o monitoreo de aplicaciones web.