Votre console cloud est verte. Vos alertes sont silencieuses. Et la file de support se remplit de clients qui ne peuvent pas se connecter.
Cette combinaison est plus courante que ce que la plupart des équipes admettent, et ce n’est généralement pas une mauvaise configuration. La surveillance cloud-native s’exécute à l’intérieur de la même infrastructure qu’elle surveille — donc, lorsque cette infrastructure connaît une mauvaise journée, sa propre télémétrie est le dernier endroit où chercher une réponse indépendante.
Si vous comparez des outils de surveillance d’infrastructure cloud en ce moment, ce déficit devrait orienter votre sélection plus que toute matrice de fonctionnalités. Ci-dessous : ce que la surveillance de votre fournisseur peut et ne peut pas voir, comment tester un fournisseur face aux pannes que vous rencontrez réellement, et quelles conditions tarifaires surprennent les équipes environ six mois après usage.
Ce Que Contient Ce Guide
- Pourquoi la surveillance de votre fournisseur cloud ne peut pas détecter la panne
- Ce que mesure réellement la surveillance cloud-native
- Trois pannes qui apparaissent en vert sur un tableau de bord cloud
- Comment évaluer un outil de surveillance d’infrastructure cloud
- Quelles métriques inclure dans votre test de présélection
- Où la tarification de la surveillance cloud piège les équipes
- Questions à poser à chaque appel avec un fournisseur
- Le point sur la surveillance d’infrastructure cloud
- Questions fréquemment posées
Pourquoi la surveillance de votre fournisseur cloud ne peut pas détecter la panne
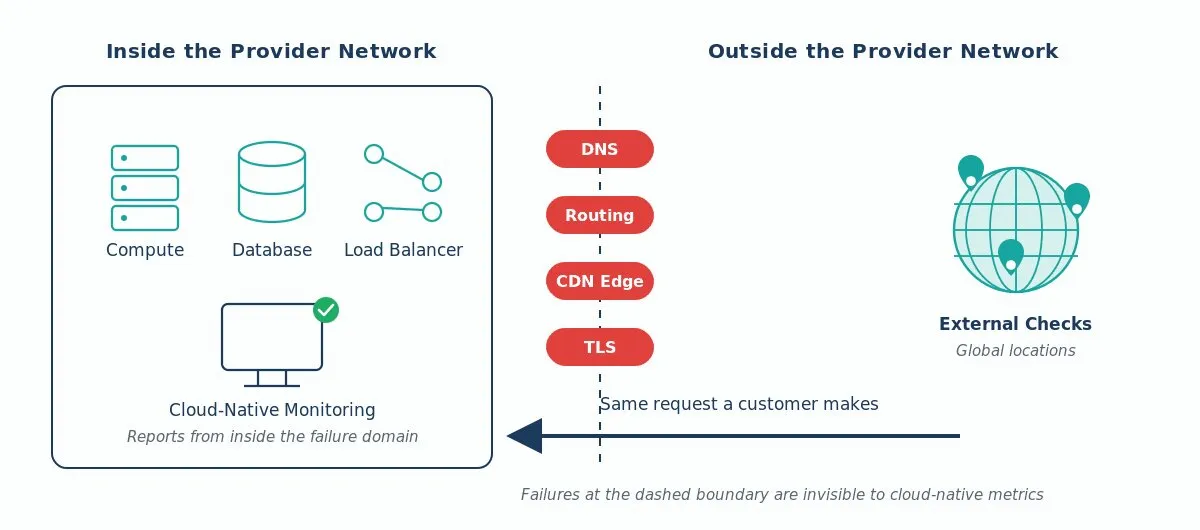
Chaque système de surveillance dispose d’un point de vue. Le point de vue de votre fournisseur se situe à l’intérieur de son propre réseau.
Une définition d’abord, car elle décide du reste de l’argumentation. La surveillance cloud-native signifie ici les métriques et alarmes par défaut des ressources que vous obtenez avec la plateforme — Amazon CloudWatch, Azure Monitor, Google Cloud Monitoring — et non pas chaque fonctionnalité de disponibilité que le fournisseur vend avec.
Ces options par défaut sont utiles. CloudWatch vous dira qu’une instance est bloquée à 100 % CPU, qu’un groupe d’Auto Scaling a ajouté de la capacité, que les connexions à la base de données sont épuisées. Ce sont de vrais signaux, et vous devez continuer à les collecter.
Mais la vérification s’exécute sur le plan de contrôle du fournisseur, via le réseau du fournisseur, contre l’API du fournisseur. Si le plan de contrôle se dégrade, le pipeline des métriques se dégrade avec. Et les métriques retardées ressemblent exactement à des métriques saines sur un tableau de bord : aucune alarme ne s’enclenche, car aucune donnée n’est arrivée qui pourrait en déclencher une.
La deuxième limite est encore plus importante pour tout ce qui est orienté client. Ces métriques par défaut mesurent vos ressources, pas le chemin entre un utilisateur à São Paulo et votre load balancer dans us-east-1. La résolution DNS, le routage BGP, le comportement du CDN sur le bord, la négociation TLS, les scripts tiers, les règles WAF — tout cela est hors de cette limite, et l’un de ces éléments peut interrompre votre service alors que CPU et mémoire restent stables.
Un système de surveillance qui vit à l’intérieur du domaine de panne est le dernier à vous dire que ce domaine est en panne.
Mais CloudWatch Synthetics ne fait-il pas déjà cela ?
En partie, et cette objection mérite d’être prise au sérieux. Chaque fournisseur majeur vend quelque chose dans ce domaine : les canaris CloudWatch Synthetics, les contrôles de santé Route 53, les tests de disponibilité Azure Monitor, les contrôles d’uptime Google Cloud. Ils effectuent de vraies requêtes contre vos points de terminaison et cela fonctionne.
Le problème est d’où ils s’exécutent. Ces contrôles fonctionnent dans la même infrastructure du fournisseur et envoient les résultats à la même console, la couverture en dehors des régions du fournisseur est mince, et un événement régional étendu peut frapper les contrôles et la charge de travail simultanément. Des outils utiles — mais pas indépendants.
L’indépendance est le vrai besoin, et il est juste de la retourner contre tout fournisseur. Beaucoup de services de surveillance tiers fonctionnent aussi sur un cloud majeur. Demandez donc où sont situés les points de contrôle : un réseau couvrant plusieurs fournisseurs et des nœuds opérés par des transporteurs, ou trois régions louées dans le cloud que vous utilisez déjà. Dotcom-Monitor exploite son propre réseau mondial de surveillance au lieu de louer des régions, ce qui rend les contrôles significatifs.
Vous pouvez construire une version de ceci. Prometheus Blackbox Exporter sonde les points de terminaison, et pour un ou deux points de vue, c’est une réponse raisonnable. Le coût apparaît quand vous avez besoin de dizaines de géographies, d’un rendu réel en navigateur, et de quelqu’un de disponible pour les sondes elles-mêmes.
Dans tous les cas, lancez la vérification en dehors du système que vous contrôlez. La surveillance synthétique envoie des requêtes via Internet public selon un planning que vous paramétrez. Si une requête échoue, vous le savez grâce au contrôle et non via un client.
Ce que mesure réellement la surveillance cloud-native
Voici la ventilation, couche par couche. Cartographiez votre couverture actuelle avant de parler à un fournisseur.
| Couche | Métriques cloud par défaut | Contrôles externes indépendants |
|---|---|---|
| CPU, mémoire, disque sur vos instances | Oui, en détail | Non |
| Santé des bases de données et files gérées | Oui | Indirectement, via le comportement de l’application |
| Événements d’autoscaling et de déploiement | Oui | Non |
| Résolution DNS publique | Partielle, depuis l’intérieur du VPC | Oui, depuis de vrais résolveurs dans le monde entier |
| Validité du certificat TLS à la périphérie | Partielle | Oui |
| Chemin réseau et routage vers les utilisateurs | Non | Oui |
| Comportement CDN et cache en périphérie | Non | Oui |
| Parcours complet de connexion ou de paiement | Non | Oui |
| Pannes API tierces et scripts | Non | Oui |
Aucune des deux colonnes ne remplace l’autre. Les outils de votre fournisseur sont le meilleur instrument pour diagnostiquer la cause racine une fois qu’on sait qu’il y a un problème. Les contrôles externes vous disent que quelque chose cloche en premier lieu — et ils continuent à rapporter quand le pipeline du fournisseur est bloqué. Notre article sur ce que couvre la surveillance d’infrastructure approfondit l’aspect niveau ressource.
Utilisez les deux. Prévoyez un budget pour les deux.
Trois pannes qui apparaissent en vert sur un tableau de bord cloud
Ce sont des tendances, pas des études de cas. Faites tourner des charges de production sur AWS, Azure ou Google Cloud pendant quelques années, et au moins un cas vous semblera familier.
Un enregistrement DNS tombé en panne pour la moitié de vos utilisateurs
Quelqu’un met à jour un enregistrement lors d’une migration. Le changement est correct au niveau du serveur de noms faisant autorité, donc toutes les vérifications internes passent. Mais le point de terminaison ancien a été décommissionné avant que le TTL précédent ne soit expiré, si bien que les résolveurs récursifs du monde entier continuent de retourner l’ancienne adresse jusqu’à l’expiration de leur cache. Une part de votre trafic continue de cibler un point qui ne répond plus.
Vos instances sont en bonne santé. Votre load balancer voit moins de trafic et ne rapporte rien d’inhabituel. Capturer ce problème signifie résoudre le nom depuis l’extérieur, depuis plusieurs géographies, comme le ferait un vrai client. C’est ce que fait la surveillance DNS, et c’est pourquoi l’emplacement des résolveurs compte dans une évaluation.
Un certificat expiré sur un load balancer
Le renouvellement est automatisé maintenant, c’est précisément pour cela que la panne est silencieuse. Un job casse, personne ne remarque, et le certificat sur un écouteur ou une propriété CDN en périphérie expire.
Les instances derrière sont correctes. Le CPU est correct. Les logs d’application montrent une chute des requêtes, pas une erreur. Les navigateurs, eux, affichent un avertissement intermédiaire à chaque visiteur. La surveillance de certificat SSL qui vérifie la chaîne depuis l’extérieur détecte cela plusieurs semaines avant.
Une région marquée comme fonctionnant normalement
Les pages de statut des fournisseurs attendent généralement une confirmation interne avant que la couleur ne change. C’est une façon raisonnable d’éviter les fausses alertes pour des millions de clients, mais cela signifie aussi que la page est souvent en retard sur l’incident. Les équipes voient régulièrement des erreurs avant que le tableau de bord ne devienne jaune.
Si votre réponse aux incidents attend la page de statut, vous laissez le temps de détection à un autre processus de revue. Les contrôles indépendants vous donnent votre propre chronologie — pendant l’incident, et après, quand vous réconciliez avec un SLA. Ce sont les données qui rendent les rapports de disponibilité et SLA valables en cas de litige.
Comment évaluer un outil de surveillance d’infrastructure cloud
La plupart des comparaisons de fournisseurs classent les fonctionnalités. Cela vous dit peu de choses — les listes de fonctionnalités ont convergé, et la moitié décrivent la même capacité sous un branding différent. Testez plutôt avec vos propres pannes.
Étape 1 : Notez les cinq derniers incidents que vous avez réellement eus. Récupérez-les dans votre système de tickets, pas de mémoire, et notez comment vous avez appris chaque incident. Si plus d’un vient d’un client, vous avez un problème de détection, pas de tableau de bord.
Étape 2 : Vérifiez d’où le fournisseur lance ses contrôles. Demandez la liste des emplacements, pas un simple nombre, et demandez qui possède ces emplacements. Trente emplacements regroupés en Amérique du Nord et Europe de l’Ouest ne disent rien sur les utilisateurs en Asie du Sud-Est. Les emplacements loués dans le cloud que vous utilisez déjà ne servent à rien en cas d’événement régional.
Étape 3 : Testez un parcours multi-étapes, pas un simple ping de page d’accueil. Un code 200 sur votre URL racine prouve presque rien. Script une connexion, une recherche, un ajout au panier, un appel API authentifié avec un identifiant de test limité. Les vérifications de code-status réussissent tous vos tests et manquent encore la panne qui vous coûte de l’argent. Le scripting EveryStep gère le cas du parcours enregistré.
Étape 4 : Cassez quelque chose volontairement pendant la période d’essai. Pointez un contrôle vers un nom d’hôte de staging que vous contrôlez, puis retirez l’enregistrement DNS ou retournez une erreur 500 dure. Chronométrez l’alerte et lisez ce qu’elle dit. C’est l’heure la plus utile que vous passerez sur un essai.
Étape 5 : Lisez l’alerte comme si elle vous réveillait. Nomme-t-elle l’étape qui a échoué, l’emplacement, la classe d’erreur, le temps de réponse ? Ou dit-elle juste « site down » ? Cette différence décide si votre ingénieur d’astreinte commence à réparer à 2h04 du matin ou commence à enquêter. Vérifiez comment l’alerte s’intègre à ce que vous utilisez déjà — PagerDuty, Slack, Teams, un webhook.
Étape 6 : Confirmez qu’elle atteint aussi vos systèmes internes. Beaucoup de ce que vous exécutez n’est pas public : panneaux d’administration, API internes, staging, tout ce qui est derrière un VPN. Un outil qui ne voit qu’Internet ouvert vous fait acheter un second. Les agents privés lancent des contrôles depuis votre réseau et rapportent à la même console.
Étape 7 : Modélisez la facture à l’échelle de l’année prochaine. Doublez vos contrôles actuels, appliquez l’intervalle que vous souhaitez réellement plutôt que celui adapté à la démo, et demandez ce chiffrage par écrit.
Quelles métriques inclure dans votre test de présélection
Le pourcentage de disponibilité finit dans le rapport au conseil, c’est le chiffre le moins utile pendant une évaluation — les chiffres de disponibilité arrondissent exactement les pannes qui vous importent. Demandez plutôt ces indicateurs :
- Temps de détection. Minutes entre le début de la panne et l’arrivée de l’alerte. C’est ce chiffre qui justifie l’achat.
- Temps de réponse par emplacement. Un p95 par région, pas une moyenne globale qui masque vos marchés lents.
- Répartition des erreurs par couche. DNS, TCP, TLS, HTTP, assertions de contenu. Un outil qui note « échec » sans nommer la couche vous renvoie la débogage.
- Comportement de confirmation d’échec. Combien d’emplacements doivent être en panne avant qu’une alerte se déclenche, et à quelle vitesse. Trop laxiste et vous obtenez du bruit ; trop strict et vous avez des délais.
- Rétention des données brutes des vérifications. Les synthèses sont suffisantes pour les rapports. La revue post-incident a besoin des contrôles individuels.
Les backend distribués compliquent cela — les dépendances échouent partiellement et les symptômes se déplacent. Notre guide sur la surveillance des systèmes distribués couvre ce cas.
Où la tarification de la surveillance cloud piège les équipes
Les factures de surveillance ont tendance à croître plus vite que l’infrastructure qu’elles surveillent. Voici où cela se produit :
Tarification par hôte dans un environnement autoscalé. Si vous êtes facturé par hôte surveillé et que votre flotte s’adapte au trafic, la facture augmente aussi. Demandez comment les instances éphémères sont comptées et sur quelle période.
Métriques personnalisées et tags à haute cardinalité. La surveillance cloud-native facture souvent par métrique personnalisée par mois. Ajoutez un tag à haute cardinalité — un ID client, un ID conteneur — et le nombre se multiplie sans qu’on décide de dépenser plus.
Ingestion, rétention, sièges, et SMS. Le volume de logs baisse rarement, alors vérifiez ce qui se passe à chaque palier et si la rétention est facturée séparément de l’ingestion. Certaines plateformes facturent aussi les utilisateurs, ce qui transforme le fait de « donner un accès en lecture au support » en discussion budgétaire, et facturent séparément SMS et alertes vocales.
Fréquence des contrôles. Chez les fournisseurs qui facturent par exécution, passer d’un intervalle de cinq minutes à une minute multiplie le coût de ce moniteur par cinq. D’autres groupent les exécutions ou limitent la fréquence selon le plan, donc la forme varie — mais ce n’est jamais gratuit, et cela détermine si vous détectez une panne courte ou non. Évaluez la fréquence que vous utiliserez réellement, par service. La tarification de Dotcom-Monitor se base par contrôle et par intervalle, donc les calculs sont faciles à faire à l’avance.
Mettez le total en regard du coût de l’indisponibilité sur votre propre service. Pour la plupart des équipes, la ligne de surveillance est petite à côté d’une seule mauvaise heure — mais ayez cette comparaison écrite avant la discussion de renouvellement.
Questions à poser à chaque appel avec un fournisseur
Apportez-les à la démo. Les réponses différencient rapidement les outils :
- Qui possède vos emplacements de contrôle — vos propres nœuds, des installations de transporteurs, ou des régions louées chez AWS, Azure ou Google Cloud ?
- Le contrôle utilise-t-il un vrai navigateur ou un client HTTP, et que change cela dans ce qui est détecté ?
- Comment surveillez-vous un point de terminaison nécessitant OAuth ou SSO ?
- Combien d’emplacements doivent échouer avant que vous alertiez, et ce paramètre est-il réglable ?
- Combien de temps conservez-vous les résultats bruts des contrôles, et puis-je les exporter ?
- À quoi ressemblerait la facture si je double mes contrôles et divise par deux mon intervalle ?
Pour le processus de sélection élargi — stabilité du fournisseur, support, conditions contractuelles — nous en avons fait un guide séparé dans nos lignes directrices pour choisir une plateforme de surveillance.
Le point sur la surveillance d’infrastructure cloud
Gardez la surveillance de votre fournisseur. C’est le meilleur outil que vous avez pour le diagnostic au niveau ressources, il est déjà déployé, et les métriques de base sont incluses avec le compute. Surveillez la facture des métriques personnalisées, des logs et de la rétention, mais conservez-le.
Ne le faites simplement pas devenir votre détecteur de panne. Il rapporte depuis l’intérieur du système qu’il surveille, et les métriques par défaut ne peuvent pas voir le chemin réseau, la résolution DNS publique, le certificat en périphérie, ou le parcours de connexion dont dépendent vos clients. Ce sont les pannes qui arrivent en premier dans votre file de support.
L’évaluation qui fonctionne est courte : listez vos incidents réels, testez les candidats contre ces pannes, cassez quelque chose pendant l’essai, évaluez la configuration que vous utiliserez réellement. Un outil qui aurait détecté vos cinq dernières pannes cinq minutes plus tôt s’est déjà payé.
Découvrez ce que détectent les contrôles externes
Dotcom-Monitor exécute des contrôles en vrai navigateur et protocolaires contre votre infrastructure cloud depuis un réseau mondial d’emplacements, plus des agents privés pour tout ce qui est derrière votre pare-feu. Lancez un essai gratuit et pointez un contrôle vers le service dont vous doutez le plus.
Explorez la surveillance d’infrastructure ou la surveillance d’applications web.