Seu console em nuvem está verde. Seus alertas estão silenciosos. E a fila de suporte está enchendo com clientes que não conseguem fazer login.
Essa combinação é mais comum do que a maioria das equipes admite, e geralmente não se trata de uma configuração incorreta. O monitoramento nativo na nuvem roda dentro da mesma infraestrutura que monitora — então, quando essa infraestrutura tem um dia ruim, sua própria telemetria é o último lugar para buscar uma resposta independente.
Se você está comparando ferramentas de monitoramento de infraestrutura em nuvem agora, essa lacuna deve guiar sua lista de finalistas mais do que qualquer matriz de funcionalidades. Abaixo: o que o monitoramento do seu provedor pode e não pode ver, como testar um fornecedor contra as falhas que você realmente tem, e quais termos de preço surpreendem as equipes cerca de seis meses depois.
O Que Este Guia Contém
- Por que o monitoramento do seu provedor de nuvem não consegue ver a queda
- O que o monitoramento nativo na nuvem realmente mede
- Três falhas que aparecem verdes em um painel de nuvem
- Como avaliar uma ferramenta de monitoramento de infraestrutura em nuvem
- Quais métricas devem estar no seu teste da lista de finalistas
- Onde a precificação de monitoramento em nuvem surpreende as equipes
- Perguntas para fazer em todas as ligações com fornecedores
- A conclusão sobre monitoramento de infraestrutura em nuvem
- Perguntas frequentes
Por Que o Monitoramento do Seu Provedor de Nuvem Não Consegue Ver a Queda
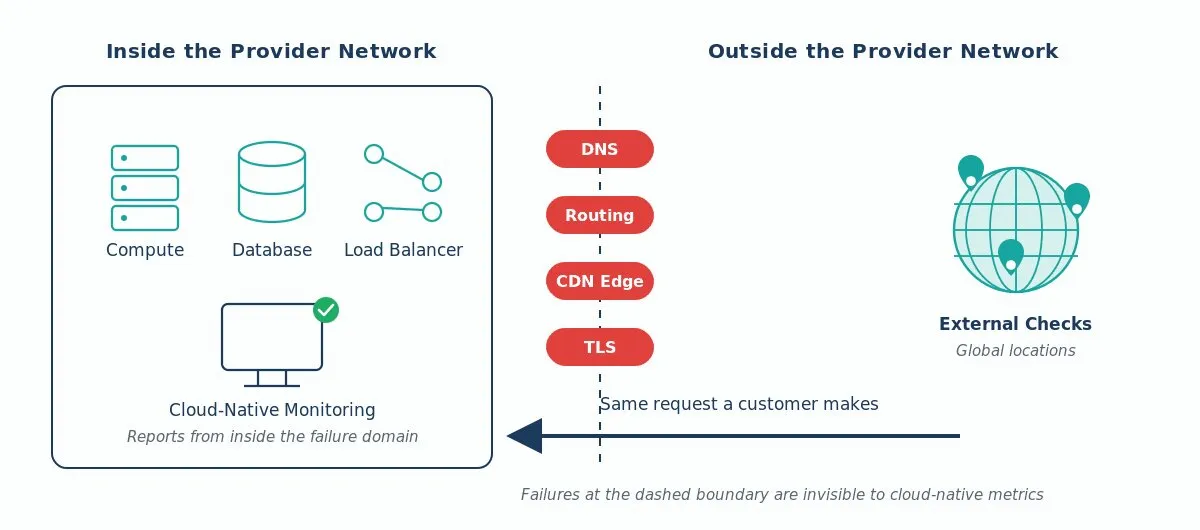
Todo sistema de monitoramento tem um ponto de vista. O ponto de vista do seu provedor está dentro da própria rede dele.
Uma definição primeiro, porque isso decide o resto do argumento. Monitoramento nativo na nuvem aqui significa as métricas e alarmes de recursos padrão que você obtém com a plataforma — Amazon CloudWatch, Azure Monitor, Google Cloud Monitoring — não todas as funcionalidades de disponibilidade que o provedor vende junto.
Esses padrões são úteis. CloudWatch vai dizer que uma instância está com CPU em 100%, que um grupo de Auto Scaling adicionou capacidade, que as conexões de banco de dados estão esgotadas. Sinais reais, e você deve continuar coletando-os.
Mas a verificação é executada no plano de controle do provedor, pela rede do provedor, contra a API do provedor. Se o plano de controle degrada, o pipeline de métricas degrada junto. E métricas atrasadas parecem exatamente como métricas saudáveis num painel: nenhum alarme dispara, porque nenhum dado chegou que acionaria um.
O segundo limite importa mais para qualquer coisa voltada ao cliente. Essas métricas padrão medem seus recursos, não o caminho entre um usuário em São Paulo e seu balanceador de carga em us-east-1. Resolução DNS, roteamento BGP, comportamento de borda CDN, negociação TLS, scripts de terceiros, regras WAF — tudo isso está fora dessa fronteira, e qualquer um pode derrubar seu serviço enquanto CPU e memória permanecem estáveis.
Um sistema de monitoramento que vive dentro do domínio de falha é o último a avisar que esse domínio está quebrado.
Mas o CloudWatch Synthetics Já Não Faz Isso?
Parcialmente, e essa objeção merece ser levada a sério. Todo provedor importante vende algo aqui: canários do CloudWatch Synthetics, verificações de saúde do Route 53, testes de disponibilidade do Azure Monitor, verificações de uptime do Google Cloud. Eles executam requisições reais contra seus endpoints e funcionam.
O problema é onde eles executam. Essas verificações rodam na mesma infraestrutura do provedor e postam resultados no mesmo console, a cobertura fora das regiões do provedor é fina, e um grande evento regional pode atingir as verificações e a carga ao mesmo tempo. Ferramentas úteis — mas não independentes.
Independência é o verdadeiro requisito, e é justo devolver essa pergunta a qualquer fornecedor. Muitos serviços de monitoramento de terceiros também rodam em uma grande nuvem. Então pergunte onde ficam as localidades das verificações: uma rede que abrange múltiplos provedores e nós operados por operadoras, ou três regiões alugadas da nuvem que você já usa. Dotcom-Monitor opera sua própria rede global de monitoramento em vez de alugar regiões, o que torna a verificação significativa.
Você pode construir uma versão disso. Prometheus Blackbox Exporter sondas endpoints, e para um ou dois pontos de vista isso é uma resposta razoável. O custo aparece quando você precisa de dezenas de geografias, renderização real em navegador, e alguém de plantão para as próprias sondas.
De qualquer forma, execute a verificação fora do sistema que está verificando. Monitoramento sintético envia requisições pela internet pública num horário que você define. Se uma falhar, você ouve isso pela verificação e não por um cliente.
O Que o Monitoramento Nativo na Nuvem Realmente Mede
Aqui está a divisão, camada por camada. Mapeie sua cobertura atual contra isso antes de falar com qualquer fornecedor.
| Camada | Métricas Padrão da Nuvem | Verificações Externas Independentes |
|---|---|---|
| CPU, memória, disco em suas instâncias | Sim, e em detalhe | Não |
| Saúde de banco de dados gerenciado e filas | Sim | Indiretamente, via comportamento do app |
| Eventos de autoscaling e implantação | Sim | Não |
| Resolução DNS pública | Parcial, dentro da VPC | Sim, de resolvedores reais no mundo |
| Validade do certificado TLS na borda | Parcial | Sim |
| Caminho de rede e roteamento aos usuários | Não | Sim |
| Comportamento de CDN e cache de borda | Não | Sim |
| Jornada completa de login ou checkout | Não | Sim |
| Falhas de API e scripts de terceiros | Não | Sim |
Nenhuma coluna substitui a outra. As ferramentas do seu provedor são o melhor instrumento para diagnóstico de causa raiz, uma vez que você sabe algo está errado. Verificações externas são o que informam que algo está errado em primeiro lugar—e continuam reportando quando o pipeline do provedor para. Nosso post sobre o que o monitoramento de infraestrutura cobre aprofunda o lado de nível de recurso.
Use ambos. Reserve orçamento para ambos.
Três Falhas Que Aparecem Verdes em um Painel de Nuvem
São padrões, não estudos de caso. Rode cargas de produção na AWS, Azure ou Google Cloud por alguns anos e pelo menos uma soará familiar.
Um Registro DNS Que Quebrou para Metade dos Seus Usuários
Alguém atualiza um registro durante uma migração. A alteração está correta no nameserver autoritativo, então toda verificação interna passa. Mas o endpoint antigo foi descomissionado antes do TTL anterior expirar, então resolvedores recursivos ao redor do mundo continuam entregando o endereço antigo até que a cópia em cache expire. Um pedaço do seu tráfego continua batendo em algo que não responde mais.
Suas instâncias estão saudáveis. Seu balanceador de carga vê menos tráfego e não reporta nada incomum. Capturar isso significa resolver o nome de fora, de várias geografias, do jeito que um cliente real faria. É o que monitoramento DNS faz, e é por isso que a localização dos resolvedores importa numa avaliação.
Um Certificado Que Expirou em um Balanceador de Carga
A renovação é automatizada hoje, e é exatamente por isso que falha silenciosamente. Um job quebra, ninguém percebe, e o certificado em um ouvinte ou uma propriedade CDN na borda expira.
As instâncias atrás dele estão boas. CPU está boa. Logs da aplicação mostram queda nas requisições, não erro. Navegadores, enquanto isso, exibem um aviso intersticial para cada visitante. Monitoramento de certificado SSL que verifica a cadeia de fora detecta isso semanas antes.
Uma Região Marcada Como Operando Normalmente
As páginas de status do provedor geralmente esperam confirmação interna antes de mudar de cor. Isso é razoável para evitar falsos alarmes entre milhões de clientes, e também significa que a página tende a atrasar o incidente. Equipes rotineiramente veem erros antes que o painel fique amarelo.
Se sua resposta a incidentes espera a página de status, você passou o tempo de detecção para o processo de revisão de outra pessoa. Verificações independentes te dão sua própria linha do tempo — durante o incidente e depois, quando você faz a reconciliação contra um SLA. Esses são os dados que tornam relatórios de uptime e SLA valiosos em disputas de crédito.
Como Avaliar uma Ferramenta de Monitoramento de Infraestrutura em Nuvem
A maioria das comparações de fornecedores classifica funcionalidades. Isso diz muito pouco — as listas de funcionalidades convergiram, e metade delas descreve a mesma capacidade com marcas diferentes. Teste contra suas próprias falhas em vez disso.
Passo 1: Anote os últimos cinco incidentes que você realmente teve. Tire-os do seu sistema de tickets, não da memória, e anote como você soube de cada um. Se mais de um veio de um cliente, você tem um problema de detecção, não de painel.
Passo 2: Verifique onde o fornecedor executa suas verificações. Peça a lista de localidades, não apenas um número, e pergunte quem é o dono dessas localidades. Trinta localidades agrupadas na América do Norte e Europa Ocidental não dizem nada sobre usuários no Sudeste Asiático. Locais alugados da nuvem que você já usa não dizem nada durante um evento regional.
Passo 3: Teste uma jornada multi-etapa, não um ping na homepage. Um 200 no URL raiz prova quase nada. Scripts de login, busca, adicionar ao carrinho, uma chamada API autenticada com uma credencial de teste específica. Verificações de código de status passam em todo teste e ainda perdem a queda que te custa dinheiro. A scriptagem EveryStep lida com o caso de jornada gravada.
Passo 4: Quebre algo de propósito durante o trial. Aponte uma verificação para um hostname de staging que você controla, depois retire o registro DNS ou retorne um 500 forte. Cronometre o alerta e leia o que ele diz. Essa será a hora mais útil do seu trial.
Passo 5: Leia o alerta como se ele te acordasse. Ele nomeia a etapa que falhou, a localização, a classe do erro, o tempo de resposta? Ou diz só “site down”? Essa diferença decide se seu engenheiro de plantão começa a consertar às 2:04 am ou começa a investigar. Veja como o alerta se integra ao que você já usa — PagerDuty, Slack, Teams, webhook.
Passo 6: Confirme que ele chega aos seus sistemas internos também. Muito do que você roda não é público: painéis administrativos, APIs internas, staging, qualquer coisa atrás de VPN. Ferramenta que só vê internet aberta te deixa comprando uma segunda. Agentes privados fazem verificações de dentro da sua rede e reportam no mesmo console.
Passo 7: Modele a conta na escala do próximo ano. Dobre seu número atual de verificações, aplique o intervalo que você realmente quer, e peça esse número por escrito.
Quais Métricas Devem Estar no Seu Teste da Lista de Finalistas
Percentual de disponibilidade acaba no deck da diretoria, e é o número menos útil durante uma avaliação — números de uptime arredondam precisamente as falhas que você se importa. Peça estas em vez disso:
- Tempo para detectar. Minutos entre o início da falha e a chegada do alerta. Esse é o número que justifica a compra.
- Tempo de resposta por localização. Um p95 por região, não uma média global que esconde seus mercados lentos.
- Detalhamento de erro por camada. DNS, TCP, TLS, HTTP, assertiva de conteúdo. Ferramenta que reporta “falhou” sem nomear a camada devolveu a depuração para você.
- Comportamento de confirmação de falha. Quantas localidades devem concordar para disparar alerta, e quão rápido. Muito aberto gera ruído; muito rigoroso gera atraso.
- Retenção de dados de checagem bruta. Resumos são bons para relatórios. Revisão pós-incidente precisa das checagens individuais.
Backends distribuídos complicam isso — dependências falham parcialmente e sintomas se movem. Nosso guia sobre monitoramento de sistemas distribuídos cobre esse caso.
Onde a Precificação de Monitoramento em Nuvem Surpreende as Equipes
Contas de monitoramento tendem a crescer mais rápido que a infraestrutura que monitoram. Onde isso acontece:
Preço por host em ambiente de autoscaling. Se você é cobrado por host monitorado e sua frota escala com o tráfego, a conta escala junto. Pergunte como instâncias efêmeras são contabilizadas e por qual janela.
Métricas customizadas e tags de alta cardinalidade. Monitoramento nativo na nuvem frequentemente cobra por métrica customizada por mês. Adicione uma tag de alta cardinalidade — ID de cliente, ID de container — e a contagem multiplica sem ninguém decidir gastar mais.
Ingestão, retenção, assentos e SMS. Volume de logs raramente diminui, então verifique o que acontece em cada limite de tier e se retenção tem preço separado da ingestão. Algumas plataformas também cobram por usuário, o que transforma “dar acesso de leitura ao suporte” em conversa de orçamento, e medem SMS e alertas de voz separadamente.
Frequência de checagem. Em fornecedores que cobram por execução, ir de intervalo de cinco minutos para um minuto multiplica o custo dessa checagem por cinco. Outros agrupam execuções ou limitam a frequência pelo nível do plano, então o formato varia — mas raramente é de graça, e decide se você pega uma queda curta ou perde ela. Preço pela frequência que você vai realmente rodar, por serviço. O preço do Dotcom-Monitor funciona por verificação e por intervalo, então essa conta é fácil de fazer à frente.
Compare o total com o custo do downtime para seu próprio serviço. Para a maioria das equipes, o custo de monitoramento é pequeno comparado a uma única hora ruim — mas tenha essa comparação por escrito antes da conversa de renovação.
Perguntas para Fazer em Todas as Ligações com Fornecedores
Leve estas para a demonstração. As respostas separam ferramentas rapidamente:
- Quem é o dono das localidades das suas verificações — seus próprios nós, instalações de operadoras ou regiões alugadas da AWS, Azure ou Google Cloud?
- A verificação usa um navegador real ou um cliente HTTP, e o que isso muda no que ela captura?
- Como você monitora um endpoint que requer OAuth ou SSO?
- Quantas localidades têm que falhar para disparar alerta, e isso é ajustável?
- Por quanto tempo você mantém resultados brutos das verificações, e posso exportá-los?
- Como fica a conta se eu dobrar minhas verificações e reduzir pela metade o intervalo?
Para o processo de seleção mais amplo — estabilidade do fornecedor, suporte, termos contratuais — escrevemos isso separadamente em nossas diretrizes para escolher uma plataforma de monitoramento.
A Conclusão Sobre Monitoramento de Infraestrutura em Nuvem
Mantenha o monitoramento do seu provedor. É o melhor instrumento que você tem para diagnóstico em nível de recurso, já está implantado, e as métricas básicas acompanham o compute. Cuidado com a conta de métricas customizadas, logs e retenção, mas mantenha.
Só não faça dele seu detector de quedas. Ele reporta de dentro do sistema que monitora, e as métricas padrão não conseguem ver o caminho de rede, a resolução DNS pública, o certificado de borda ou o fluxo de login do qual seus clientes dependem. Essas são as falhas que chegam primeiro na sua fila de suporte.
A avaliação que funciona é curta: liste seus incidentes reais, teste candidatos contra essas falhas, quebre algo durante o trial, precifique a configuração que você realmente vai usar. Uma ferramenta que teria detectado suas últimas cinco quedas cinco minutos antes já valeu o investimento.
Veja o Que Verificações Externas Detectam
Dotcom-Monitor executa verificações de navegador real e por protocolo contra sua infraestrutura em nuvem a partir de uma rede global de localidades, além de agentes privados para qualquer coisa atrás do seu firewall. Inicie um teste gratuito e aponte uma verificação para o serviço sobre o qual você tem menos certeza.
Explore monitoramento de infraestrutura ou monitoramento de aplicação web.