Ihre Cloud-Konsole ist grün. Ihre Alarme sind still. Und die Support-Warteschlange füllt sich mit Kunden, die sich nicht anmelden können.
Diese Kombination ist häufiger, als die meisten Teams zugeben, und in der Regel keine Fehlkonfiguration. Cloud-native Überwachung läuft innerhalb derselben Infrastruktur, über die sie berichtet – wenn diese Infrastruktur jedoch einen schlechten Tag hat, ist deren Telemetrie der letzte Ort, um eine unabhängige Antwort zu erhalten.
Wenn Sie gerade Cloud-Infrastruktur-Monitoring-Tools vergleichen, sollte diese Lücke Ihre engere Auswahl mehr beeinflussen als jede Feature-Matrix. Im Folgenden: was die Überwachung Ihres Anbieters sehen kann und was nicht, wie Sie einen Anbieter gegen die Ausfälle testen, die Sie tatsächlich haben, und welche Preiskonditionen Teams etwa sechs Monate später überraschen.
Was in diesem Leitfaden enthalten ist
- Warum die Überwachung Ihres Cloud-Anbieters den Ausfall nicht sehen kann
- Was Cloud-native Überwachung tatsächlich misst
- Drei Ausfälle, die auf einem Cloud-Dashboard grün angezeigt werden
- Wie man ein Cloud-Infrastruktur-Monitoring-Tool bewertet
- Welche Metriken in Ihren Kurzlistentest gehören
- Wo Cloud-Monitoring-Preise Teams in die Falle locken
- Fragen, die man bei jedem Anbieteranruf stellen sollte
- Das Fazit zum Cloud-Infrastruktur-Monitoring
- Häufig gestellte Fragen
Warum die Überwachung Ihres Cloud-Anbieters den Ausfall nicht sehen kann
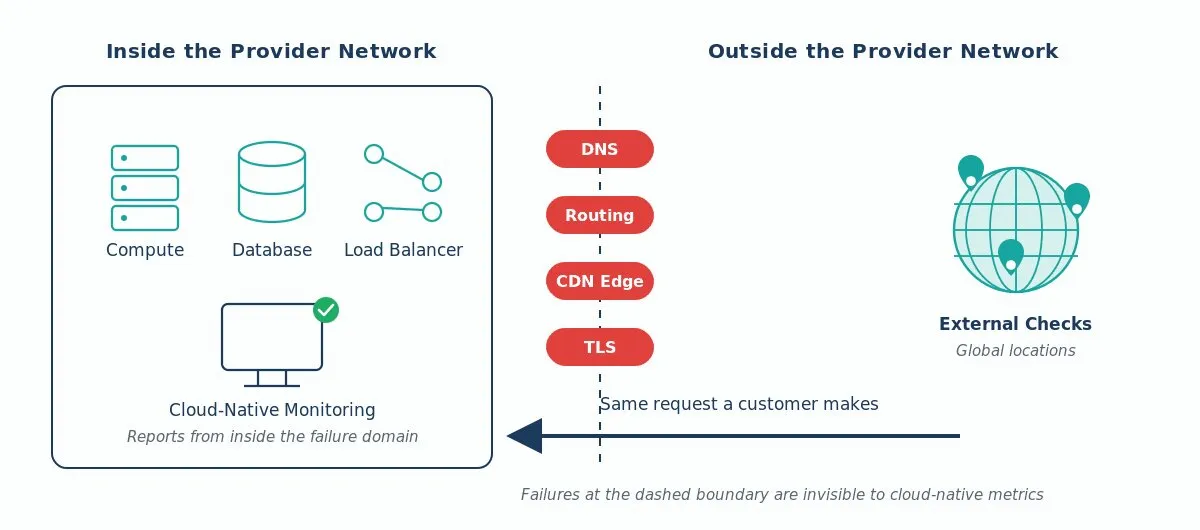
Jedes Überwachungssystem hat einen Standpunkt. Der Standpunkt Ihres Anbieters befindet sich innerhalb seines eigenen Netzwerks.
Zunächst eine Definition, denn sie bestimmt den Rest der Argumentation. Cloud-native Überwachung bedeutet hier die Standard-Ressourcenmetriken und Alarme, die Sie mit der Plattform erhalten – Amazon CloudWatch, Azure Monitor, Google Cloud Monitoring – nicht jede Verfügbarkeitsfunktion, die der Anbieter daneben verkauft.
Diese Defaults sind nützlich. CloudWatch wird Ihnen sagen, dass eine Instanz mit 100 % CPU-Auslastung arbeitet, dass eine Auto Scaling-Gruppe Kapazität hinzugefügt hat, dass Datenbankverbindungen erschöpft sind. Echte Signale, und Sie sollten diese weiter sammeln.
Aber die Prüfung läuft auf der Steuerungsebene des Anbieters, über das Netzwerk des Anbieters, gegen die API des Anbieters. Wenn die Steuerungsebene beeinträchtigt ist, ist die Metrik-Pipeline ebenfalls beeinträchtigt. Verzögerte Metriken sehen auf einem Dashboard genau so aus wie gesunde Metriken: kein Alarm wird ausgelöst, da keine Daten eintreffen, die einen Alarm auslösen würden.
Die zweite Begrenzung ist wichtiger für alles, was kundenorientiert ist. Diese Standardmetriken messen Ihre Ressourcen, nicht den Pfad zwischen einem Nutzer in São Paulo und Ihrem Load Balancer in us-east-1. DNS-Auflösung, BGP-Routing, CDN-Edge-Verhalten, TLS-Aushandlung, Skripte von Drittanbietern, WAF-Regeln – all das liegt außerhalb dieser Grenze, und jeder dieser Punkte kann Ihren Service lahmlegen, während CPU und Speicher stabil bleiben.
Ein Überwachungssystem, das innerhalb der Fehlerdomäne lebt, ist das letzte, das Ihnen sagt, dass diese Domäne gestört ist.
Aber macht CloudWatch Synthetics das nicht schon?
Zum Teil, und dieser Einwand ist ernst zu nehmen. Jeder große Anbieter verkauft etwas in diese Richtung: CloudWatch Synthetics Kanarienvögel, Route 53 Health Checks, Azure Monitor Verfügbarkeitstests, Google Cloud Uptime-Checks. Sie führen echte Anfragen an Ihre Endpunkte aus und funktionieren.
Der Haken ist, von wo sie ausgeführt werden. Diese Prüfungen werden auf der Infrastruktur desselben Anbieters ausgeführt und die Ergebnisse im gleichen Dashboard gepostet, die Abdeckung außerhalb der Regionen dieses Anbieters ist dünn und ein großes regionales Ereignis kann die Prüfungen und die Workload gleichzeitig treffen. Nützliche Tools – aber keine unabhängigen.
Unabhängigkeit ist die eigentliche Anforderung, und es ist legitim, das jedem Anbieter zurückzugeben. Viele Drittanbieter-Überwachungsdienste laufen ebenfalls in einer großen Cloud. Fragen Sie also, wo die Prüfstandorte sind: ein Netzwerk, das mehrere Anbieter und carrierbetriebene Nodes umfasst, oder drei gemietete Regionen der Cloud, die Sie bereits nutzen. Dotcom-Monitor betreibt sein eigenes globales Überwachungsnetzwerk, statt Regionen zu mieten, was die Prüfung aussagekräftig macht.
Sie können eine Version davon selbst bauen. Prometheus Blackbox Exporter prüft Endpunkte und für einen oder zwei Standpunkte ist das eine vernünftige Lösung. Die Kosten zeigen sich, wenn Sie Dutzende Geografien, echtes Browser-Rendering und jemanden benötigen, der selbst für die Prüfungen zuständig ist.
So oder so: Führen Sie die Prüfung von außerhalb des Systems aus, das Sie prüfen. Synthetische Überwachung sendet Anfragen über das öffentliche Internet nach einem Zeitplan, den Sie festlegen. Wenn eine fehlschlägt, erfahren Sie es von der Prüfung und nicht von einem Kunden.
Was Cloud-native Überwachung tatsächlich misst
Hier die Aufteilung, Schicht für Schicht. Vergleichen Sie Ihre aktuelle Abdeckung damit, bevor Sie mit einem Anbieter sprechen.
| Schicht | Standard Cloud-Metriken | Unabhängige externe Checks |
|---|---|---|
| CPU, Speicher, Festplatte auf Ihren Instanzen | Ja, und detailliert | Nein |
| Gesundheit verwalteter Datenbanken und Warteschlangen | Ja | Indirekt, über das Verhalten der App |
| Auto-Scaling- und Deployment-Ereignisse | Ja | Nein |
| Öffentliche DNS-Auflösung | Teilweise, von innerhalb der VPC | Ja, von echten Resolvern weltweit |
| Gültigkeit des TLS-Zertifikats am Edge | Teilweise | Ja |
| Netzwerkpfad und Routing zu Nutzern | Nein | Ja |
| Verhalten von CDN und Edge-Cache | Nein | Ja |
| Kompletter Login- oder Checkout-Prozess | Nein | Ja |
| Fehler bei Drittanbieter-APIs und Skripten | Nein | Ja |
Keine Spalte ersetzt die andere. Das Werkzeug Ihres Anbieters ist das bessere Instrument zur Ursachenanalyse, sobald Sie wissen, dass etwas nicht stimmt. Externe Prüfungen sagen Ihnen überhaupt erst, dass etwas nicht stimmt – und sie berichten weiter, wenn die Pipeline des Anbieters selbst ausfällt. Unser Beitrag zu was Infrastruktur-Monitoring abdeckt geht auf die ressourcenbezogene Seite ein.
Führen Sie beides aus. Planen Sie das Budget für beides ein.
Drei Ausfälle, die auf einem Cloud-Dashboard grün angezeigt werden
Dies sind Muster, keine Fallstudien. Betreiben Sie produktive Workloads auf AWS, Azure oder Google Cloud für ein paar Jahre, und mindestens einer davon wird vertraut wirken.
Ein DNS-Eintrag, der für die Hälfte Ihrer Nutzer nicht mehr funktionierte
Jemand aktualisiert einen Eintrag während einer Migration. Die Änderung ist beim autoritativen Nameserver korrekt, sodass jeder interne Check erfolgreich ist. Aber der alte Endpunkt wurde vor Ablauf des vorherigen TTL außer Dienst gestellt, sodass rekursive Resolver weltweit die alte Adresse ausliefern, bis ihre zwischengespeicherte Kopie abläuft. Ein Teil Ihres Traffics trifft weiterhin auf etwas, das nicht mehr reagiert.
Ihre Instanzen sind gesund. Ihr Load Balancer sieht weniger Traffic und meldet nichts Ungewöhnliches. Das Einfangen dieses Problems bedeutet, den Namen von außerhalb, aus mehreren Regionen aufzulösen, so wie es ein echter Kunde tun würde. Das macht DNS-Monitoring, und deshalb ist der Standort des Resolvers bei der Bewertung wichtig.
Ein Zertifikat, das auf einem Load Balancer abgelaufen ist
Die Erneuerung ist jetzt automatisiert, genau deshalb schlägt sie stillschweigend fehl. Ein Job bricht zusammen, niemand merkt es und das Zertifikat an einem Listener oder einer CDN-Edge-Eigenschaft läuft ab.
Die dahinterliegenden Instanzen sind in Ordnung. CPU ist in Ordnung. Anwendungsprotokolle zeigen einen Rückgang der Anfragen, aber keinen Fehler. Browser hingegen zeigen jedem Besucher eine Zwischenwarnung an. SSL-Zertifikat-Überwachung, die die Kette von außen überprüft, erkennt dies Wochen im Voraus.
Eine Region, die als normal arbeitend markiert ist
Statusseiten von Anbietern warten normalerweise auf eine interne Bestätigung, bevor sich die Farbe ändert. Das ist ein vernünftiger Weg, um Fehlalarme bei Millionen von Kunden zu vermeiden, und bedeutet auch, dass die Seite dem Vorfall meist hinterherhinkt. Teams sehen Fehler routinemäßig, bevor das Dashboard gelb wird.
Wenn Ihre Vorfallreaktion auf die Statusseite wartet, haben Sie die Erkennungszeit an den Überprüfungsprozess eines anderen abgegeben. Unabhängige Prüfungen geben Ihnen Ihre eigene Zeitleiste – während des Vorfalls und danach, wenn Sie gegen eine SLA vergleichen. Das sind die Daten, die Uptime- und SLA-Berichte bei Streitigkeiten wertvoll machen.
Wie man ein Cloud-Infrastruktur-Monitoring-Tool bewertet
Die meisten Anbieter-Vergleiche bewerten Funktionen. Das sagt Ihnen sehr wenig – die Feature-Listen sind konvergiert, und die Hälfte beschreibt dieselbe Fähigkeit unter verschiedenen Marken. Testen Sie stattdessen gegen Ihre eigenen Ausfälle.
Schritt 1: Schreiben Sie die letzten fünf tatsächlichen Vorfälle auf. Ziehen Sie sie aus Ihrem Ticketsystem, nicht aus dem Gedächtnis, und notieren Sie, wie Sie von jedem erfahren haben. Wenn mehr als einer von einem Kunden kam, haben Sie ein Erkennungsproblem, kein Dashboard-Problem.
Schritt 2: Prüfen Sie, von wo aus der Anbieter seine Checks ausführt. Fragen Sie nach der Standortliste, nicht nach einer Anzahl, und fragen Sie, wem diese Standorte gehören. Dreißig Standorte, die in Nordamerika und Westeuropa konzentriert sind, sagen nichts über Nutzer in Südostasien aus. Von der Cloud gemietete Standorte, die Sie bereits nutzen, sind bei einem regionalen Ereignis unbrauchbar.
Schritt 3: Testen Sie eine mehrstufige Reise, nicht nur einen Homepage-Ping. Ein 200er-Statuscode auf Ihrer Root-URL beweist fast nichts. Scripten Sie einen Login, eine Suche, einen Warenkorb hinzuzufügen, einen API-Aufruf authentifiziert mit einem eingeschränkten Test-Credential. Statuscode-Prüfungen bestehen jeden Test und verpassen trotzdem den Ausfall, der Sie Geld kostet. EveryStep-Skripting behandelt den Fall der aufgezeichneten Reise.
Schritt 4: Brechen Sie absichtlich etwas während der Testphase. Richten Sie einen Check auf einen Staging-Hostnamen, den Sie kontrollieren, und ziehen Sie dann den DNS-Eintrag oder geben Sie einen harten 500-Fehler zurück. Stoppen Sie die Zeit bis der Alarm ausgelöst wird und lesen Sie, was er sagt. Diese Stunde ist die nützlichste, die Sie in jedem Test verbringen.
Schritt 5: Lesen Sie den Alarm so, als würde er Sie wecken. Nennt er den fehlerhaften Schritt, den Standort, die Fehlerklasse, die Antwortzeit? Oder sagt er nur “Seite ausgefallen”? Dieser Unterschied entscheidet, ob Ihr Bereitschaftsingenieur um 2:04 Uhr mit der Behebung beginnt oder mit der Untersuchung. Prüfen Sie, wie Benachrichtigungen in das bereits genutzte System eingeleitet werden – PagerDuty, Slack, Teams, ein Webhook.
Schritt 6: Bestätigen Sie, dass es auch Ihre internen Systeme erreicht. Vieles, was Sie betreiben, ist nicht öffentlich: Admin-Panels, interne APIs, Staging, alles hinter einer VPN. Ein Tool, das nur das offene Internet sieht, zwingt Sie, ein zweites zu kaufen. Private Agents führen Checks von innerhalb Ihres Netzwerks aus und berichten im selben Dashboard.
Schritt 7: Modellieren Sie die Kosten für die Skalierung im nächsten Jahr. Verdoppeln Sie Ihre aktuelle Check-Anzahl, wenden Sie das Intervall an, das Sie tatsächlich wollen, nicht das, das gut zur Demo passt, und fordern Sie diese Zahl schriftlich an.
Welche Metriken in Ihren Kurzlistentest gehören
Die Verfügbarkeitsprozentzahl endet im Vorstandsdokument und ist während einer Bewertung die am wenigsten nützliche Zahl – Uptime-Werte runden genau die Ausfälle weg, die Sie interessieren. Fragen Sie stattdessen diese an:
- Zeit bis zur Erkennung. Minuten zwischen Beginn des Ausfalls und Eintreffen des Alarms. Diese Zahl rechtfertigt den Kauf.
- Antwortzeit nach Standort. Ein p95 pro Region, nicht ein globaler Durchschnitt, der langsame Märkte versteckt.
- Fehleraufteilung nach Schicht. DNS, TCP, TLS, HTTP, Inhaltsprüfung. Ein Tool, das “fehlgeschlagen” meldet ohne die Schicht zu benennen, schiebt die Fehlerbehebung zurück zu Ihnen.
- Verhalten bei Fehlerbestätigung. Wie viele Standorte müssen zustimmen, bevor ein Alarm ausgelöst wird, und wie schnell. Zu locker bedeutet Lärm; zu streng bedeutet Verzögerung.
- Aufbewahrung der Roh-Check-Daten. Zusammenfassungen sind gut für Berichte. Nachträgliche Überprüfungen benötigen die einzelnen Checks.
Verteilte Backends erschweren das – Abhängigkeiten fallen teilweise aus und die Symptome verlagern sich. Unser Leitfaden zum Monitoring verteilter Systeme behandelt diesen Fall.
Wo Cloud-Monitoring-Preise Teams in die Falle locken
Monitoring-Rechnungen wachsen meist schneller als die Infrastruktur, die sie überwachen. Das passiert hier:
Preis pro Host in einer Auto-Scaling-Umgebung. Wenn Sie pro überwachten Host abgerechnet werden und Ihre Flotte mit dem Traffic skaliert, wächst die Rechnung entsprechend. Fragen Sie, wie flüchtige Instanzen gezählt werden und über welchen Zeitraum.
Benutzerdefinierte Metriken und Tags mit hoher Kardinalität. Cloud-native Überwachung berechnet oft monatlich pro benutzerdefinierter Metrik. Fügen Sie einen Tag mit hoher Kardinalität hinzu – eine Kunden-ID, eine Container-ID – und die Anzahl vervielfacht sich, ohne dass jemand mehr ausgeben möchte.
Ingest, Aufbewahrung, Benutzer und SMS. Log-Datenvolumen sinkt selten, prüfen Sie, was an jeder Stufengrenze passiert und ob Aufbewahrung separat vom Ingest berechnet wird. Manche Plattformen berechnen auch pro Nutzer, was “Unterstützung mit Leserechten geben” in eine Budget-Diskussion verwandelt, und rechnen SMS- und Sprachnachrichten separat ab.
Check-Frequenz. Bei Anbietern, die pro Ausführung abrechnen, vervielfacht sich die Kosten eines Monitors beim Wechsel von fünf Minuten auf eine Minute um das Fünffache. Andere bündeln Ausführungen oder begrenzen die Frequenz je nach Tarifstufe, die Kosten variieren, aber frei ist es selten, und es entscheidet, ob Sie einen kurzen Ausfall erkennen oder verpassen. Kalkulieren Sie die Frequenz, die Sie tatsächlich laufen lassen, pro Dienst. Dotcom-Monitor preist pro Check und Intervall, was die Kalkulation vergünstigt.
Setzen Sie die Gesamtsumme den Kosten der Ausfallzeit Ihres eigenen Dienstes gegenüber. Für die meisten Teams ist der Posten für Monitoring gering im Vergleich zu einer einzelnen schlechten Stunde – haben Sie diesen Vergleich vor dem Verlängerungsgespräch schriftlich vorliegen.
Fragen, die man bei jedem Anbieteranruf stellen sollte
Bringen Sie diese zur Demo mit. Die Antworten trennen Werkzeuge schnell:
- Wem gehören Ihre Prüfstandorte – eigene Nodes, Betreiberanlagen oder Regionen, die von AWS, Azure oder Google Cloud gemietet sind?
- Verwendet die Prüfung einen echten Browser oder einen HTTP-Client, und was ändert das an dem, was sie erfasst?
- Wie überwachen Sie einen Endpunkt, der OAuth oder SSO erfordert?
- Wie viele Standorte müssen ausfallen, bevor Sie alarmieren, und ist das konfigurierbar?
- Wie lange bewahren Sie Roh-Check-Ergebnisse auf, und kann ich sie exportieren?
- Wie sieht die Rechnung aus, wenn ich meine Checks verdopple und mein Intervall halbieren?
Für den breiteren Auswahlprozess – Anbieterstabilität, Support, Vertragskonditionen – haben wir separat unsere Richtlinien zur Wahl einer Monitoring-Plattform veröffentlicht.
Das Fazit zum Cloud-Infrastruktur-Monitoring
Behalten Sie die Überwachung Ihres Anbieters. Es ist das beste Instrument zur Ursachenanalyse auf Ressourcenebene, bereits implementiert und die Basis-Metriken sind im Compute enthalten. Behalten Sie die Kosten für benutzerdefinierte Metriken, Logs und Aufbewahrung im Auge, aber behalten Sie es.
Machen Sie es nur nicht zu Ihrem Ausfalldetektor. Es berichtet von innerhalb des Systems, das es überwacht, und die Standardmetriken sehen nicht den Netzwerkpfad, die öffentliche DNS-Auflösung, das Edge-Zertifikat oder den Login-Prozess, auf den Ihre Kunden angewiesen sind. Das sind die Ausfälle, die zuerst in Ihrer Support-Warteschlange landen.
Die funktionierende Bewertung ist kurz: Listen Sie Ihre realen Vorfälle auf, testen Sie Kandidaten gegen diese Ausfälle, brechen Sie während der Testphase etwas absichtlich, kalkulieren Sie die Konfiguration, die Sie tatsächlich betreiben werden. Ein Tool, das Ihre letzten fünf Ausfälle jeweils fünf Minuten früher erkannt hätte, hat sich bezahlt gemacht.
Sehen Sie, was externe Checks erfassen
Dotcom-Monitor führt echte Browser- und Protokollprüfungen gegen Ihre Cloud-Infrastruktur von einem globalen Netzwerk aus Standorten durch, plus private Agents für alles hinter Ihrer Firewall. Starten Sie eine kostenlose Testphase und richten Sie einen Check für den Dienst ein, bei dem Sie am wenigsten sicher sind.
Infrastruktur-Monitoring erkunden oder Webanwendungs-Monitoring erkunden.