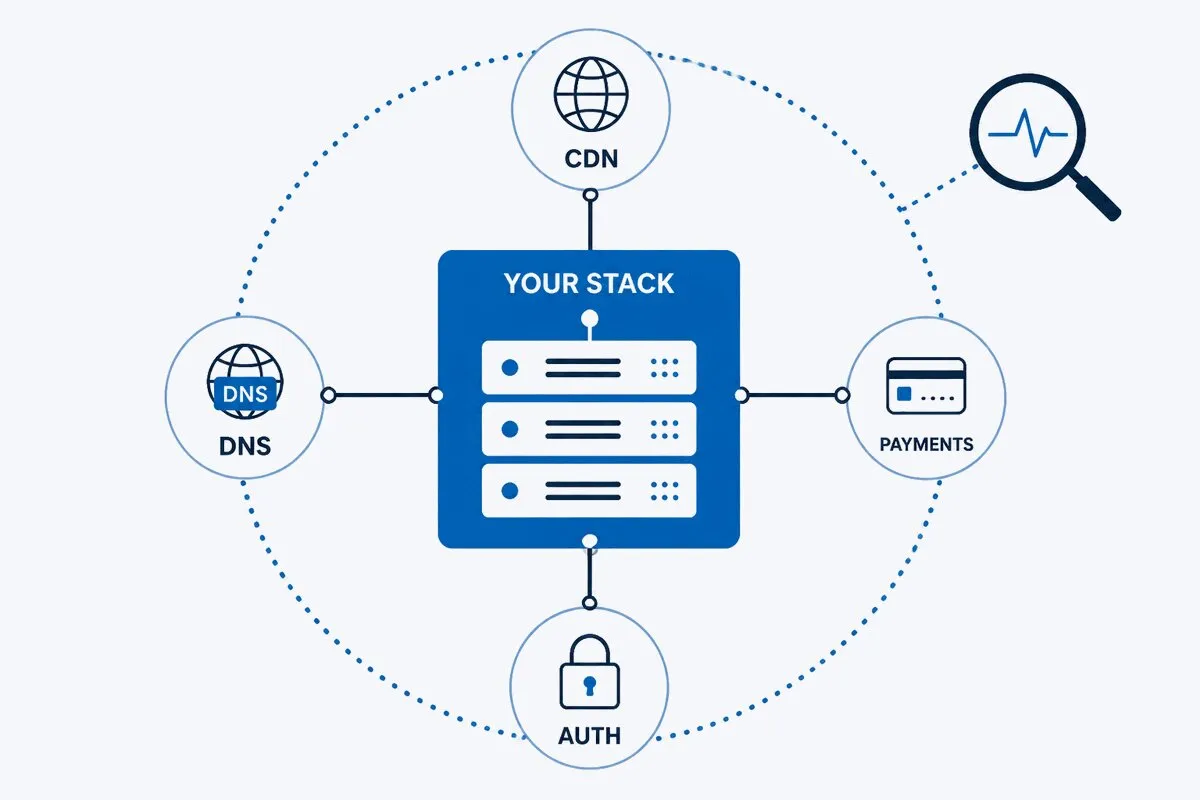
Die sieben SRE-Prinzipien stammen von einem Unternehmen, das seine Rechenzentren, sein Netzwerk, seine Load-Balancer und jede Codezeile dazwischen besitzt. Ihr Stack sieht wahrscheinlich anders aus. Ein großer Teil dessen, was Ihre Nutzer erleben, läuft auf Infrastruktur, in die Sie nicht per SSH gelangen können: ein CDN, ein Authentifizierungsanbieter, ein Zahlungs-Gateway, DNS, ein Tag-Manager, eine Partner-API.
Diese Lücke ist entscheidend, denn die Prinzipien gelten auch außerhalb von Google. Aber einige ändern ihre Form, wenn die fehlerhafte Komponente nicht in Ihrer Hand liegt. Ein Error Budget verhält sich anders, wenn ein Drittel davon durch einen Ausfall eines anderen verursacht wird. Die vier goldenen Signale sehen von außerhalb der Firewall anders aus als von innen. Und das Risiko, das Sie nicht wegintegrieren können, müssen Sie messen.
Dieser Artikel erklärt alle sieben Prinzipien so, wie das Google SRE Buch sie definiert, und ergänzt den Teil, den das Buch überspringt: Wie jedes Prinzip aussieht, wenn Sie von Diensten abhängig sind, die Sie nicht kontrollieren. Wenn Sie neu in der Rolle sind, starten Sie mit was ein Site Reliability Engineer macht und kommen Sie dann zurück.
Was sind die SRE-Prinzipien?
SRE-Prinzipien sind die Arbeitsregeln, die Google für den Betrieb zuverlässiger Systeme im großen Maßstab formuliert hat: Risiko annehmen und managen, Service Level Objectives, Beseitigung von Toil, Monitoring, Automatisierung, Release Engineering und Einfachheit. Zusammen beantworten sie eine Frage: Wie zuverlässig muss dieser Dienst sein und was ist der günstigste nachhaltige Weg, ihn dort zu halten?
Die Liste hat sich seit Veröffentlichung des SRE-Buchs 2016 nicht geändert. Was sich geändert hat, ist der durchschnittliche Stack. Microservices, SaaS-Abhängigkeiten und Drittanbieter-Skripte bedeuten, dass ein Teil Ihrer Zuverlässigkeit jetzt in den Händen anderer Unternehmen liegt. Jeder der folgenden Abschnitte behandelt das Prinzip so, wie es geschrieben ist, und dann, was kaputtgeht, wenn die Abhängigkeit nicht Ihnen gehört. Am Ende gibt es eine kurze Liste von SRE Best Practices, die aus allen sieben Prinzipien abgeleitet sind.
Prinzip 1 – Risiko annehmen und managen
Die Google-Formulierung: 100 % Zuverlässigkeit ist das falsche Ziel. Nutzer erreichen Sie über Netzwerke und Geräte, die von selbst ausfallen; jenseits eines bestimmten Punktes kosten zusätzliche Neunen echtes Geld und niemand merkt den Unterschied. Wählen Sie ein Zuverlässigkeitsziel, das das Unternehmen vertreten kann, und behandeln Sie die Lücke zwischen diesem Ziel und Perfektion als Budget, das Sie für Features ausgeben dürfen. Das Kapitel Risiko annehmen erläutert das im Detail.
Innerhalb von Google funktioniert das, weil Risiko ein Regler ist, den sie drehen können. Mehr Replikation, mehr Redundanz, langsamere Rollouts: Geld ausgeben, mehr Neunen.
Außerhalb von Google ist der Regler an manchen Stellen gar nicht angeschlossen. Sie können Ihrem Zahlungs-Gateway keine Replik hinzufügen. Sie können das Failover-Verhalten Ihres DNS-Anbieters nicht einstellen. Deren Zuverlässigkeit ist ein Vertragspunkt, kein technischer Parameter.
Das Prinzip ändert also seine Form: Für Komponenten, die Sie besitzen, managen Sie Risiko durch Engineering. Für die, die Sie nicht besitzen, managen Sie es durch Messung. Sie müssen die reale Verfügbarkeit Ihres Auth-Anbieters messen, gemessen von der Nutzerseite aus, nicht die Zahl auf dessen Statusseite. Statusseiten zeigen bei Teil-Ausfällen oft grün an, und eine Abhängigkeit, die in ihrem eigenen Rechenzentrum läuft, kann von Ihrem aus unerreichbar sein. Unabhängige Messung wandelt „Wir denken, das CDN ist unzuverlässig“ in ein verlängerbares Gespräch mit Datenunterlegung. Das ist der erste Job, den Dotcom-Monitor hier übernimmt: eine externe Prüfung jeder kritischen Abhängigkeit. Ein DNS-Check auf die Nameserver des Anbieters, ein HTTP(S)-Check am CDN-Edge, ein API-Check gegen das Zahlungs-Gateway. Jeder baut eine eigene Verfügbarkeits- und Antwortzeit-Historie aus einem globalen Netzwerk auf. Und wo die Zahlen es rechtfertigen, umfahren Sie das Risiko: ein zweiter DNS-Anbieter, ein Backup-Zahlungsweg, eine zwischengespeicherte Kopie des Drittanbieter-Skripts.
Wie man Risikomanagement umsetzt
- Listen Sie jede Abhängigkeit auf, die eine Nutzeranfrage berührt (DNS, CDN, Auth, Zahlungen, Drittanbieter-Tags), und markieren Sie, welche Sie technisch managen und welche Sie nur messen können.
- Erstellen Sie für jede Mess-Abhängigkeit ein Dotcom-Monitor-Gerät: eine DNS-Task auf die Nameserver des Anbieters, eine HTTP(S)-Task am CDN-Edge, eine Webservices-Task gegen das Zahlungs- oder Auth-Endpunkt.
- Führen Sie diese Checks von mehreren Monitoring-Standorten in den Regionen Ihrer Nutzer aus, damit ein regionaler Ausfall beim Anbieter nicht durch eine gesunde Region verdeckt wird.
- Bringen Sie jedem Anbieter-Gespräch den Uptime-Bericht jedes Geräts ein und fügen Sie Routing-Fallbacks (sekundärer DNS, Backup-Zahlungspfad) nur dort hinzu, wo die Daten das Risiko rechtfertigen.
Prinzip 2 – Service Level Objectives (SLA, SLO, SLI)
Drei Begriffe werden ständig verwechselt, hier die Klarstellung:
- SLA (Service Level Agreement): der Vertrag. Was Sie Kunden versprechen, mit Strafen, wenn Sie es nicht erfüllen.
- SLO (Service Level Objective): das Ziel für einen Service Level Indikator, typischerweise intern und strenger als das SLA, damit Sie Ihren Alarm vorher auslösen und nicht den Vertrag brechen. Zum Beispiel 99,9 % Verfügbarkeit, Checkout dauert weniger als 3 Sekunden, solche Ziele.
- SLI (Service Level Indicator): die Messung selbst. Die tatsächliche Verfügbarkeitszahl, die Antwortzeit, die beobachtete Fehlerquote.
Der SLI misst, das SLO ist das Ziel, das SLA das Versprechen. Alles, was daraus folgt, einschließlich der Verfügbarkeits- und SLA-Berichte, die Sie einem Kunden geben, hängt davon ab, dass der SLI vertrauenswürdig ist.
Und an dieser Stelle haben die meisten Teams eine blinde Stelle: Ein Error Budget ist nur so genau wie die Messung dahinter. Wenn Ihre Checks alle 5 Minuten laufen, hat jeder aufgezeichnete Ausfall einen Start und ein Ende, das jeweils nur auf 5 Minuten genau bekannt ist, und Ausfälle, die kürzer als das Intervall sind, können unbemerkt enden. Das bewirkt das für ein monatliches Error Budget bei gängigen SLO-Zielen, basierend auf einem 30-Tage-Monat (43.200 Minuten):
| Monatliches SLO | Error Budget (30-Tage-Monat) | Kleinster Ausfall, den ein 5-Minuten-Check zuverlässig erkennt | Ein 5-Minuten-Intervall als % des Budgets |
|---|---|---|---|
| 99,0% | 7h 12m (432 min) | 5 min | 1,2% |
| 99,5% | 3h 36m (216 min) | 5 min | 2,3% |
| 99,9% | 43m 12s (43,2 min) | 5 min | 11,6% |
| 99,95% | 21m 36s (21,6 min) | 5 min | 23,1% |
| 99,99% | 4m 19s (4,32 min) | 5 min | 116 %, mehr als das ganze Budget |
Sie können ein monatliches SLO von 99,99 % nicht mit 5-Minuten-Checks messen. Ein einzelnes Check-Intervall ist größer als Ihr gesamtes monatliches Error Budget.
Die Wahrscheinlichkeitsrechnung ist genauso unerbittlich. Bei einem Check-Intervall I Minuten wird ein zufälliger Ausfall von D Minuten Dauer (wobei D kürzer als I ist) mit etwa der Wahrscheinlichkeit D/I erkannt, angenommen der Ausfallstart ist unabhängig vom Check-Zeitplan. Ein 4-minütiger Ausfall bei 5-minütigem Intervall wird also etwa vier von fünf Malen erkannt, die restliche 1-in-5 Chance ist, dass der Ausfall komplett zwischen zwei Checks liegt und gar nicht erfasst wird. Für längere Ausfälle ist die mittlere Erkennungs-Verzögerung etwa die Hälfte des Intervalls, also fügen 5-Minuten-Checks im Durchschnitt 2,5 Minuten Verzögerung hinzu, bevor überhaupt jemand Bescheid weiß.
Eine Einschränkung: Die Tabelle geht von einem einzelnen geplanten Check und intervallbasierter Downtime-Erfassung aus. Bestätigungen an mehreren Standorten und anfragebasierte SLIs ändern die Details, nicht das Stichprobenproblem.
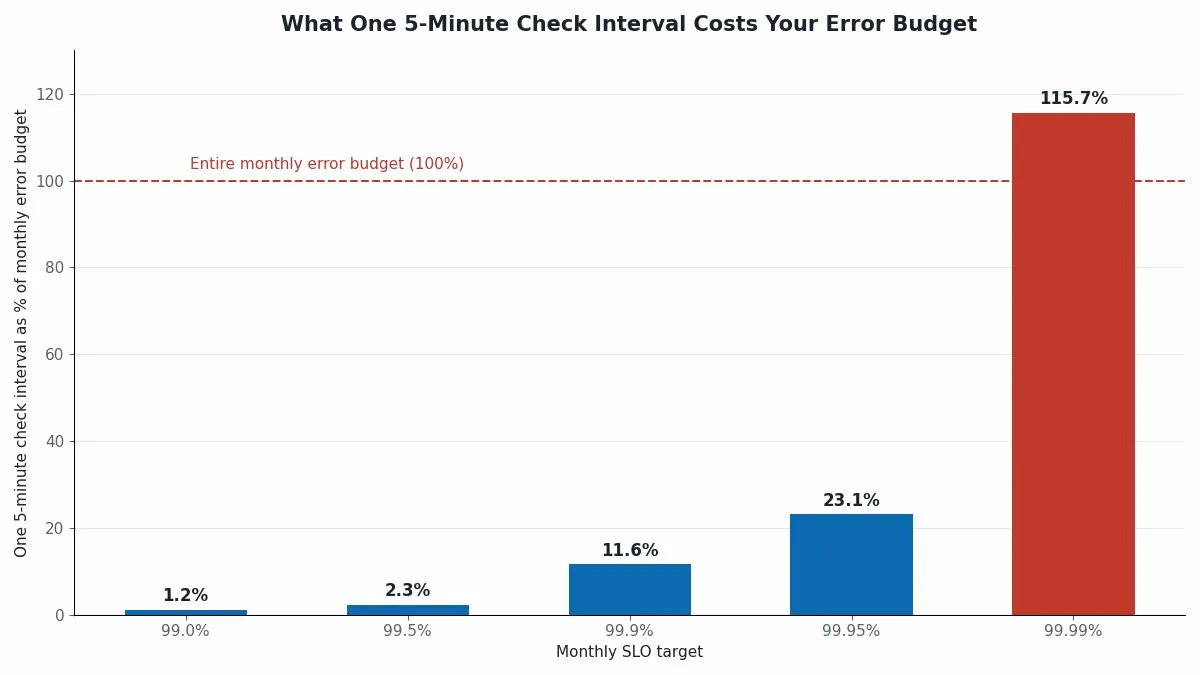
Kurze Ausfälle sind auch kein Randfall. Von allen Ausfällen, die Dotcom-Monitor erkennt, werden etwa 38 % innerhalb von 5 Minuten behoben. Das sind meist Netzwerk-Routing-Fehler, Neustarts, Failover, die sich selbst beheben, bevor jemand eingreifen könnte, und unser Response Filter hält genau aus diesem Grund die Benachrichtigung zurück. Aber ausgefiltert aus der Alarmierung heißt nicht ausgefiltert aus der Aufzeichnung: Diese Downtime zählt trotzdem gegen das SLA, intern oder beim Anbieter, und muss weiterhin berücksichtigt werden. Von den Ausfällen, die alarmieren, sind über 56 % innerhalb von 15 Minuten nach der ersten Benachrichtigung behoben, ca. 18 % dauern über eine Stunde, und etwa 3 % ziehen sich länger als 24 Stunden. Die Verteilung variiert leicht je nach Diensttyp, aber das Muster bleibt: Mehr als ein Drittel aller Ausfälle liegen in der Kategorie, die ein 5-Minuten-Check kaum erkennen kann. Deshalb ist die Check-Frequenz eine Messungsentscheidung, keine Kostenfrage: Bei 1-Minuten-Checks sinkt das Messquantum auf 2,3 % des 99,9 % Monatsbudgets anstelle von 11,6 %, und die kurzen Ausfälle, die die meisten Vorfälle verursachen, tauchen in Ihrem Bericht auf. Deshalb führt Dotcom-Monitor Checks so häufig wie jede Minute durch und baut sein SLA-Reporting auf derselben Aufzeichnung auf: Die Compliance-Zahl, die Sie einem Kunden zeigen, ist nur so vertrauenswürdig wie die zugrunde liegende Stichprobe.
Wie man Service Level Objectives umsetzt
- Definieren Sie zwei oder drei SLIs, die Ihre Nutzer erkennen würden, wie Verfügbarkeit gemessen von einem echten Browser oder Checkout-Dauer, und machen Sie einen Dotcom-Monitor-Check zur offiziellen Messquelle für jeden einzelnen.
- Setzen Sie jedes SLO strenger als das SLA, das es schützt, und setzen Sie dann die Checkfrequenz des Geräts passend zur Stufe: Laut Tabelle oben benötigen alle SLOs über 99,9 % 1-Minuten-Checks.
- Planen Sie Verfügbarkeits- und SLA-Berichte an die Verantwortlichen für das SLA-Gespräch, damit die Compliance-Zahl aus der selben Check-Aufzeichnung wie die Alarme stammt.
- Vereinbaren Sie vorab, was passiert, wenn das Error Budget aufgebraucht ist, bevor jemand über einen konkreten Vorfall diskutieren muss.
Prinzip 3 – Beseitigung von Toil
Toil ist manuelle, sich wiederholende Arbeit, die mit der Größe des Dienstes wächst und keinen bleibenden Wert schafft. Das Kapitel Beseitigung von Toil legt ein berühmtes Limit fest: SREs sollen nicht mehr als die Hälfte ihrer Zeit damit verbringen, und den Rest mit Engineering, das den Toil verschwinden lässt.
Abstrakte Definitionen machen Toil leicht zum Nicken, aber schwer zu finden. Benennen Sie ihn also. In den meisten Teams sieht das so aus:
- Jemand loggt sich jeden Morgen ein, um zu bestätigen, dass der Checkout noch funktioniert.
- Jemand testet das Anmeldeformular nach jedem Deployment manuell.
- Jemand behält Erinnerungen für das Ablaufdatum von SSL-Zertifikaten im Kalender.
- Jemand ruft manuell eine Partner-API auf, wenn Support-Tickets steigen, um herauszufinden, ob das Problem bei Ihnen oder beim Partner liegt.
Jede dieser Tätigkeiten ist ein Skript-Transaktion, die darauf wartet, geschrieben zu werden, und hier verdient Dotcom-Monitor seinen Lohn am direktesten. Ein Script, aufgezeichnet mit EveryStep, dem Point-and-Click-Transaktionsrekorder, durchläuft den gleichen Checkout-Weg alle paar Minuten über einen echten Browser und löst einen Alarm aus, sobald ein Schritt fehlschlägt. Die Zertifikats-Checks überwachen Ablaufdaten ohne Kalender. Die API-Checks prüfen die Partner-Endpunkte getaktet und führen eine Antwortzeit-Historie, die den Streit „wir oder die“ auf einen Blick klärt.
Der Prüfstein, was zuerst automatisiert wird, ist nicht Komplexität, sondern Wiederholung. Der Check, den ein Mensch täglich macht, soll eine Maschine jede Minute ausführen.
Wie man Toil-Beseitigung umsetzt
- Führen Sie eine einwöchige Liste aller manuellen Checks, die jemand im Team durchführt; Wiederholung, nicht Schwierigkeit, bestimmt, was zuerst automatisiert wird.
- Nehmen Sie den häufigsten Check als EveryStep-Script auf, indem Sie den Ablauf einmal durchklicken, und lassen Sie ihn dann alle paar Minuten laufen statt nur einmal morgens.
- Ersetzen Sie den Kalender für Zertifikatablauf durch Dotcom-Monitor-SSL-Zertifikatschecks, und legen Sie Partner-APIs als geplante Webservices-Checks an, so dass niemand sie aus dem Gedächtnis verwalten muss.
- Verfolgen Sie vierteljährlich die eingesparten Stunden manueller Checks, damit die Automatisierungsarbeit sichtbar und finanziert bleibt.
Prinzip 4 – Monitoring und die vier goldenen Signale
Das Kapitel Monitoring verteilter Systeme nennt vier goldene Signale: Latenz, Verkehr, Fehler und Auslastung. Beobachten Sie diese vier und Sie fangen die meisten Probleme ab.
Das Kapitel erwähnt Black-Box-Monitoring, aber die meisten Teams instrumentieren alle vier Signale von innen aus. Beobachten Sie sie lieber von dort, wo Ihre Nutzer sitzen, und drei der vier zeigen sich anders:
| Signal | Innen (APM, Prometheus, Server-Metriken) | Außen (externe synthetische Checks) |
|---|---|---|
| Latenz | Anwendungs- und Datenbankzeit. Schließt alles aus, was passiert, bevor die Anfrage Ihre Server erreicht. | DNS + TCP + TLS + CDN-Edge + Übertragung + Rendern. Die Zeit, die der Nutzer tatsächlich spürt. |
| Verkehr | Anfragen pro Sekunde, vollständig sichtbar. | Extern nicht beobachtbar. Ein synthetischer Check erzeugt eigenen Verkehr; er sieht Ihren nicht. |
| Fehler | 5xx-Rate, Ausnahmezählungen. | HTTP 200 mit kaputtem Checkout. Das Drittanbieter-Script, das still fehlschlägt. Das Seitelement, das nie dargestellt wurde. |
| Auslastung | CPU, Speicher, Warteschlangentiefe, Verbindungs-Pools. | Nicht direkt messbar. Abgeleitet aus Latenzverschlechterung bei steigender Last. |
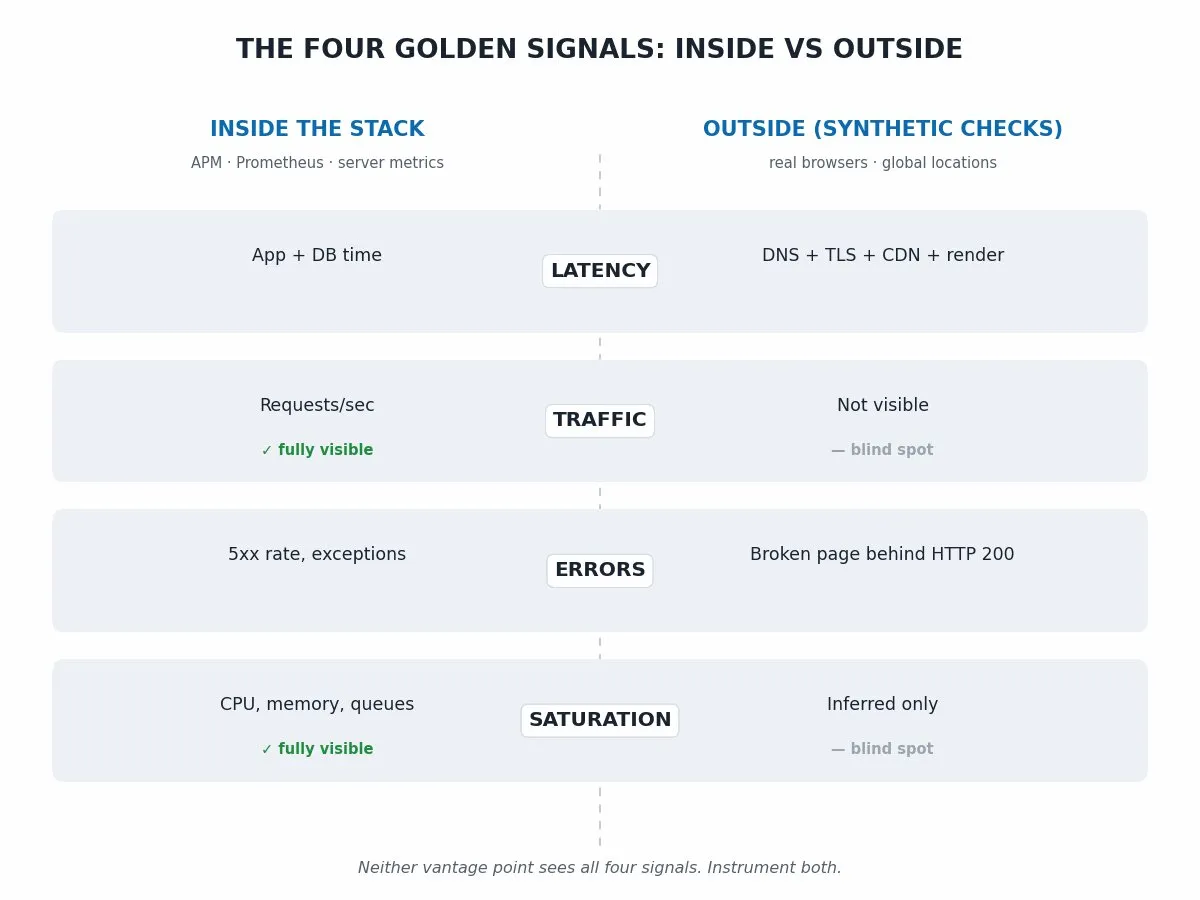
Lesen Sie die Tabelle ehrlich und die Schlussfolgerung ist nicht „Außen ist besser.“ Sondern, dass keine Sicht alles sieht. Verkehr und Auslastung gehören zu Ihren internen Tools: Prometheus, Datadog, New Relic, was auch immer Ihre APM-Umgebung ist. Latenz und Fehler, wie sie erlebt werden, gehören zum externen synthetischen Monitoring. Das ist die Hälfte, die Dotcom-Monitor abdeckt. Real-Browser-Checks aus einem globalen Netzwerk laden Ihre Seiten so, wie Nutzer das tun, und messen den ganzen Pfad: DNS-Auflösung, TLS-Handshake, CDN-Edge, Seiten-Rendern, Skript-Nutzeraktionen. Protokoll-Checks für HTTP(S), API, DNS, TCP und ICMP überwachen die Abhängigkeiten um die Seite herum. Die beiden Perspektiven konkurrieren nicht, sie sind unterschiedliche Sichtweisen auf dieselben vier Signale, und Sie brauchen beide.
Die praktische Regel: Jedes Signal, das Ihre Nutzer spüren können, muss zumindest einmal von dort gemessen werden, wo Ihre Nutzer sind. Ein APM-Dashboard, das grün zeigt, während das CDN der Hälfte Europas gecachte Fehlerseiten serviert, ist kein theoretischer Fall. Es ist der Standard-Fehlermodus bei rein internem Monitoring.
Wie man Monitoring umsetzt
- Behalten Sie Verkehr und Auslastung im APM- oder Prometheus-Stack; überlassen Sie Latenz und Fehler den Dotcom-Monitor Real-Browser-Checks aus den Regionen, in denen Ihre Nutzer tatsächlich sind.
- Richten Sie Inhaltsprüfungen für diese Checks ein, nicht nur Statuscode-Checks, damit ein kaputter Checkout hinter einem HTTP 200 genauso versagt wie für den Nutzer.
- Erstellen Sie Skripte für die wichtigen Transaktionen (Login, Suche, Checkout) mit EveryStep, so dass das Monitoring denselben Pfad geht wie Ihre Nutzer.
- Vergleichen Sie regelmäßig die Innen- und Außenzahlen; die Lücke zwischen ihnen ist Ihre CDN-, DNS- und Drittanbieterschicht.
Prinzip 5 – Automatisierung
Der SRE-Grund für Automatisierung ist Konsistenz im großen Maßstab. Menschen vergessen Schritte, Maschinen nicht, und jede Reaktion, die um 3 Uhr morgens passieren muss, darf nicht von einem um 3 Uhr wachen Menschen abhängen.
Der Teil, der außerhalb von Google anders ist: Automatisierung ist nur so gut wie das Signal, das sie auslöst. Failover-Skripte, Rollback-Tasks und Auto-Scaling-Regeln feuern alle auf ein Detektionsevent, also fügt jede Minute Verzögerung in der Erkennung eine Minute zu jeder automatisierten Reaktion hinzu, die Sie gebaut haben. Die Mathematik aus dem SLO-Abschnitt gilt direkt: ein automatisiertes Failover, das von einem 5-Minuten-Check ausgelöst wird, gibt dem Ausfall einen durchschnittlichen Vorsprung von 2,5 Minuten.
Und manche Automatisierungstrigger können nur von außen kommen. Ein Skript, das auf einen Backup-Zahlungsanbieter umschaltet, muss wissen, dass der primäre Anbieter für Nutzer ausfällt, nicht nur, dass dessen Health-Endpoint auf Pings im selben Netzwerk antwortet. Dotcom-Monitor schließt diese Schleife, indem es Alarme und Webhooks aus seinen externen Checks auslöst, so dass das Failover auf dem basiert, was Nutzer erleben, nicht auf dem, was der Health-Endpoint behauptet.
Wie man Automatisierung umsetzt
- Beginnen Sie mit den Reaktionen, die Sie bei Vorfällen heute manuell durchführen: Neustarts, Failover, Rollbacks.
- Verbinden Sie Dotcom-Monitor Alarm-Webhooks mit den Skripten, die sie ausführen, so dass der Trigger ein extern bestätigter Ausfall und nicht nur ein interner Health-Check ist.
- Nutzen Sie Alarm-Eskalationsgruppen, so dass die erste Benachrichtigung die Person oder das System erreicht, das handelt, nicht ein gemeinsames Postfach, das um 3 Uhr morgens keiner beobachtet.
- Lassen Sie den Response Filter selbstbehebende Kurz-Ausfälle absorbieren, damit sie Ihre Automatisierungen nicht auslösen, und prüfen Sie die Trigger vierteljährlich auf Fehlalarme.
Prinzip 6 – Release Engineering
Release Engineering ist die Disziplin, Software jedes Mal gleich zu bauen und auszuliefern: versionierte Builds, reproduzierbare Pipelines, Rollbacks, die funktionieren, weil sie geprobt wurden.
Modernes CI/CD deckt das meiste davon im Pipeline-Ablauf ab. Tests laufen durch, Artefakte werden gebaut, Deployments gehen hinter Feature-Flags raus. Was die Pipeline nicht sagen kann, ist, ob das System nach dem Deployment für Nutzer funktioniert. CI beweist den Build; es sagt nichts über den DNS-Eintrag, der sich nicht propagiert hat, den CDN-Cache, der das alte Bundle serviert, das Drittanbieter-Tag, das in Kombination mit Ihrem neuen Code kaputtging, oder den Konfig-Wert, der nur in Produktion existiert.
Diese Lücke füllt die Verifikation nach dem Deployment. Ein EveryStep-Skript, das den kritischen Pfad durchläuft (Seite laden, einloggen, Transaktion abschließen), ausgeführt aus dem Dotcom-Monitor-Netzwerk gegen die Produktion unmittelbar nach jedem Release, ist der einzige Test, der wirklich das prüft, was Nutzer bekommen. Teams, die diese Methode nutzen, behandeln sie als finale Stufe der Pipeline: deployen, von außen verifizieren und erst dann den Release als abgeschlossen markieren. Wenn der Check fehlschlägt, wird das Rollback ausgelöst, solange der Schadensradius noch in Minuten gemessen wird.
Wie man Release Engineering umsetzt
- Versionieren Sie jeden Build und machen Sie Rollbacks zu einer geprobten Ein-Schritt-Aktion, nicht zu einer improvisierten.
- Machen Sie eine EveryStep-Transaktion gegen Produktion zur letzten Pipeline-Stufe, ausgeführt aus dem Dotcom-Monitor-Netzwerk, damit DNS, CDN-Cache und Drittanbieter-Tags Teil des Tests sind.
- Richten Sie den Alarm-Webhooks des Checks so ein, dass eine fehlgeschlagene Ausführung nach Deployment zum automatischen Rollback-Signal wird, nicht zu einem Ticket für den nächsten Morgen.
- Lassen Sie den gleichen Check zwischen Releases weiterlaufen; dessen Historie ist Ihre Basislinie dafür, ob ein Deployment die Performance verschlechtert hat.
Prinzip 7 – Einfachheit
Das Kapitel Einfachheit argumentiert, dass Zuverlässigkeit und Komplexität sich gegeneinander abwägen: jede Komponente, die Sie hinzufügen, ist eine weitere Komponente, die ausfallen kann, und Software sollte genau so komplex sein, wie es der Job erfordert.
Wenden Sie das auf den Monitoring-Stack selbst an, denn Monitoring ist der Ort, an dem sich Komplexität still ansammelt. Teams enden mit einem APM-Tool, einer Log-Plattform, einem Uptime-Pinger, einem Statusseiten-Service und drei Dashboards, die niemand öffnet. Jedes Tool alarmiert nach eigenem Plan, und das Gesamtresultat ist Alarmmüdigkeit: so viele Benachrichtigungen, dass die Wichtige unter den Tisch fiel.
Ein Monitoring-Anbieter, der Ihnen sagt, weniger Monitoring-Tools zu verwenden, ist ein ungewöhnliches Argument, genau deshalb lohnt es sich. Der Einfachheitstest für einen Monitoring-Stack hat zwei Fragen. Erstens: Wissen Sie bei jeder überwachten Sache, welches Tool maßgeblich ist, wenn zwei uneinig sind? Zweitens: Gibt es für jeden Alarm jemanden, der darauf reagiert? Wenn ein Tool für alles, was es überwacht, beide Fragen verneint, ist es kein Monitoring, sondern Lärm mit Abo-Gebühr. Die Konsolidierung von Uptime Monitoring, Transaktions-, API- und Infrastrukturchecks in einer Plattform mit einem Alarmierungsweg ist eine Einfachheitsentscheidung vor der Kaufentscheidung. So ist Dotcom-Monitor gebaut: diese Checks an einem Ort, ein Alarmierungsweg, parallel zum APM-Tool, das das Innere beobachtet, statt es zu ersetzen.
Wie man Einfachheit umsetzt
- Inventarisieren Sie Ihre Monitoring-Tools und schreiben Sie für jedes auf, wofür es maßgeblich ist.
- Löschen Sie jeden Alarm ohne Besitzer und ohne zugehörige Aktion; wenn niemand reagiert, ist es Lärm.
- Fassen Sie die externen Checks (Uptime, Seite, Transaktion, API, Infrastruktur) in Dotcom-Monitor als eine Plattform mit einem Alarmierungsweg zusammen und lassen Sie Ihr APM das Innere behalten.
- Wiederholen Sie das Audit jährlich; Monitoring Stacks regenerieren Komplexität von allein.
SRE Best Practices
Die Prinzipien sagen, worauf man abzielt. Hier sind die Praktiken, die sich in Teams bewähren, die nicht ihren ganzen Stack besitzen:
- Setzen Sie SLOs auf das, was Nutzer erleben, nicht auf das, was Server melden. „Checkout dauert weniger als 4 Sekunden aus einem echten Browser“ ist ein nutzererkennbares SLO. „API p95 unter 200ms“ ist ein Input dafür.
- Stellen Sie die Check-Frequenz auf Ihr SLO ein. Laut obiger Error-Budget-Tabelle: Bei 99,95 % verbraucht ein 5-Minuten-Intervall schon 23 % des Monatsbudgets, bei 99,99 % überschreitet es das Budget komplett. Behandeln Sie 1-Minuten-Checks ab 99,95 % als praktische Untergrenze.
- Überwachen Sie Ihre Abhängigkeiten so, wie Sie sich selbst überwachen. DNS, CDN, Zahlung, Auth: Ein externer Check pro kritischer Abhängigkeit, mit eigener Antwortzeit-Historie. Wenn deren Statusseite grün sagt und Ihre Nutzer sagen kaputt, entscheidet diese Messung.
- Schreiben Sie die Error-Budget-Policy, bevor Sie das Budget ausgeben. Vereinbaren Sie im Voraus, was passiert, wenn das Budget aufgebraucht ist: Feature-Einfrierungen, Zuverlässigkeits-Sprints, Postmortem-Prioritäten. Ein Budget ohne Policy ist eine Grafik, auf die niemand reagiert.
- Üben Sie den Incident-Response, bevor Sie ihn brauchen. Rufbereitschaften, Eskalationswege und schuldlose Nachbesprechungen sind ausführlich in unserem SRE Incident Management-Guide behandelt.
- Halten Sie die Tool-Anzahl im Rahmen. Überprüfen Sie den Monitoring-Stack jährlich anhand der zwei Einfachheitsfragen oben. Unsere Übersicht der SRE-Tools behandelt die Kategorien, die sich lohnen.
- Machen Sie Zuverlässigkeitsberichte zur Gewohnheit, nicht zum Notfall. Geplante Verfügbarkeits- und SLA-Berichte sorgen dafür, dass das Compliance-Gespräch auf gemeinsamen Zahlen basiert, statt auf aufwendiger Log-Auswertung nach einem Streit.
Das Fazit
Die sieben SRE-Prinzipien überlebten den Weg hinaus aus Google. Was nicht überlebte, ist die Annahme dahinter: dass das Team, das sie anwendet, den Stack kontrolliert, auf den sie angewendet werden. Das tun Sie nicht, und das ändert die Arbeit. Risiko, das Sie nicht technisch beheben können, muss gemessen werden. Error Budgets sind nur so real, wie das Check-Intervall dahinter. Internes Werkzeug beherrscht Verkehr und Auslastung; die vom Nutzer erlebte Seite von Latenz und Fehlern zeigt sich nur von außen. Die Verifikation nach Deployment muss von außen laufen, weil nur dort das gesamte System existiert.
Der gemeinsame Faden ist Messung von außen. Jedes Prinzip, angewendet auf einen Stack voller fremder Komponenten, braucht eine unabhängige Sichtweise: pro Abhängigkeit Checks für Risiko, 1-Minuten-Intervalle für Error Budgets, echte Browser für die goldenen Signale, skriptgesteuerte Transaktionen für Toil und Releases, eine Plattform für Einfachheit. Das ist die Rolle, die Dotcom-Monitor bei allen sieben spielt. Kein Tool-Präferenz – sondern das, was die Prinzipien verlangen, sobald der Stack nicht mehr Ihnen gehört.
Messen Sie den Stack, den Sie nicht besitzen
Führen Sie Real-Browser-Checks in 1-Minuten-Intervallen aus einem globalen Netzwerk durch und sehen Sie, was in Ihrem Error Budget gefehlt hat. Starten Sie eine kostenlose Testversion.
